
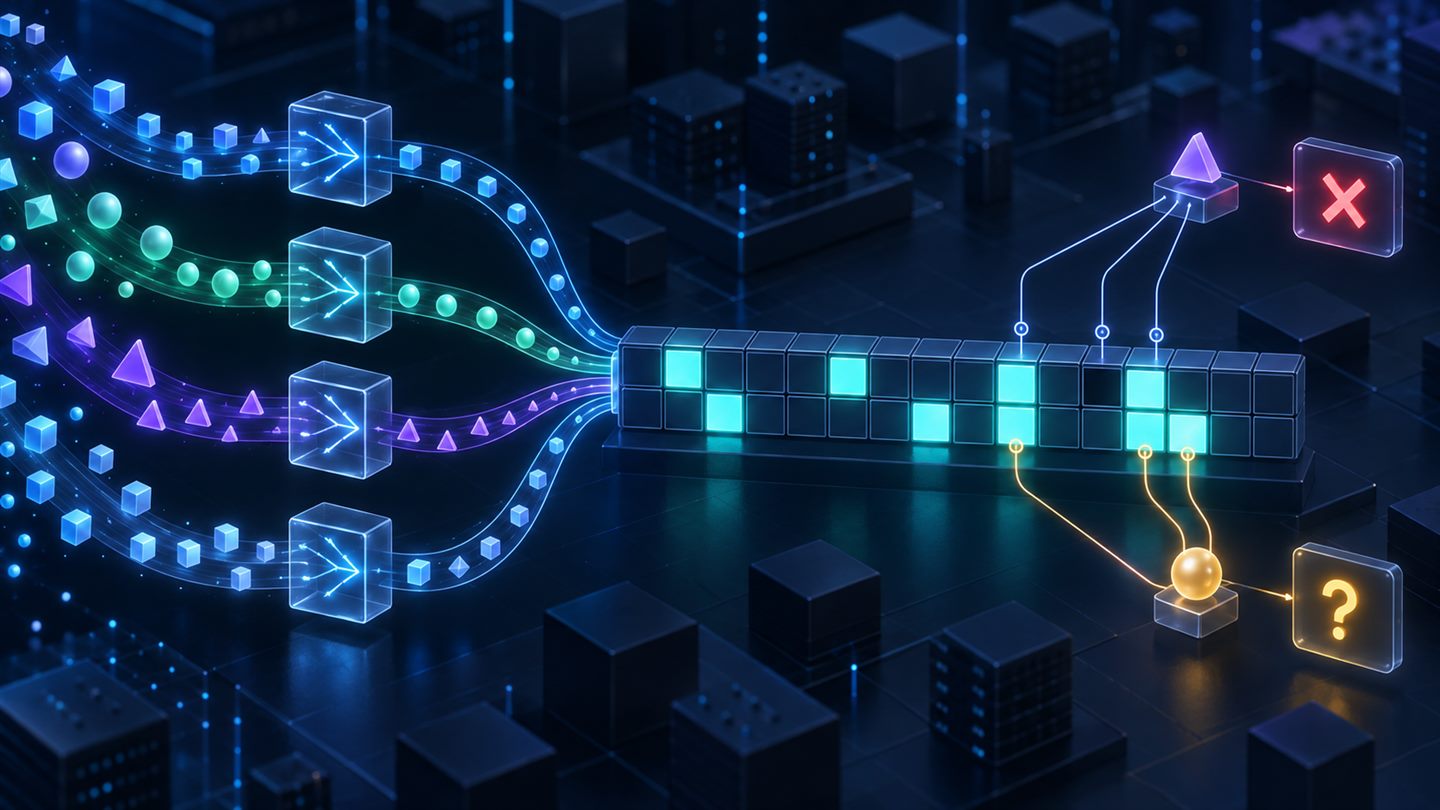
Bloom filter là cấu trúc dữ liệu xác suất giúp trả lời nhanh câu hỏi “phần tử này có thuộc tập không?” bằng một lượng bộ nhớ rất nhỏ. Nó không lưu chính các phần tử mà chỉ lưu dấu vết của chúng trong một mảng bit. Đổi lại, câu trả lời có semantics đặc biệt: chắc chắn không tồn tại hoặc có thể tồn tại.
Đặc tính đó biến Bloom filter thành lớp gác cổng hữu ích trước một thao tác đắt đỏ như đọc ổ đĩa, truy vấn dịch vụ từ xa hay kiểm tra một bảng lớn. Tuy nhiên, nó không phải tập hợp chính xác và không được dùng như nguồn sự thật. Muốn triển khai đúng, kỹ sư cần hiểu dương tính giả, cách chọn kích thước và điều gì xảy ra khi filter vượt quá dung lượng thiết kế.
1. Bài toán Bloom filter giải quyết
Giả sử dịch vụ phải kiểm tra hàng triệu ID trước khi truy cập kho dữ liệu. Một hash set chính xác cần giữ khóa hoặc fingerprint đủ lớn; gọi thẳng storage cho mọi request lại tốn I/O. Bloom filter đứng ở phía trước:
- Nếu filter trả về
false, phần tử chắc chắn chưa được thêm vào filter. - Nếu filter trả về
true, phần tử có thể đã được thêm; hệ thống phải kiểm tra nguồn dữ liệu chính xác.
Lỗi chỉ xảy ra theo một chiều trong mô hình Bloom filter chuẩn: một phần tử chưa từng thêm vẫn có thể nhận kết quả “có thể có” vì các bit cần thiết tình cờ đã được phần tử khác bật. Đây là false positive. Nếu không xóa bit tùy tiện, phần tử đã thêm không tạo false negative.
Bloom filter tối ưu đường đi âm tính: loại nhanh phần lớn phần tử chắc chắn không có, rồi dành phép kiểm tra đắt tiền cho số ít trường hợp còn lại.
2. Cấu tạo: mảng bit và nhiều vị trí băm
Một Bloom filter có mảng m bit, ban đầu đều bằng 0, và k phép ánh xạ băm. Khi thêm phần tử x, hệ thống tính k chỉ số trong khoảng [0, m-1] rồi đặt tất cả bit tương ứng thành 1. Khi truy vấn, nó tính lại đúng các chỉ số đó:
add(x):
  for i in 1..k:
    bits[index(hash_i(x), m)] = 1

mightContain(x):
  for i in 1..k:
    if bits[index(hash_i(x), m)] == 0:
      return false
  return true
Chỉ một bit bằng 0 là bằng chứng phần tử chưa từng được thêm, vì thao tác thêm lẽ ra phải bật bit đó. Ngược lại, tất cả bit bằng 1 chưa phải bằng chứng tuyệt đối: chúng có thể là tổng dấu vết của nhiều phần tử khác.
3. Dương tính giả xuất hiện như thế nào?
Càng thêm nhiều phần tử, tỷ lệ bit 1 càng cao. Khi mảng gần bão hòa, một truy vấn ngẫu nhiên dễ gặp đủ k bit đã bật. Với giả định hàm băm phân bố tốt, sau khi thêm n phần tử, xác suất dương tính giả thường được xấp xỉ:
p ≈ (1 - e^(-k n / m))^kGiữ m và n cố định, dùng quá ít hàm băm không khai thác đủ mảng bit; dùng quá nhiều lại bật bit quá nhanh và tăng chi phí CPU. Giá trị gần tối ưu là:
k ≈ (m / n) ln(2)Công thức mô tả kỳ vọng, không phải cam kết rằng một request cụ thể không bao giờ sai. Tỷ lệ quan sát còn phụ thuộc phân phối input, chất lượng hash, số phần tử thực tế và cách đo workload.
4. Chọn dung lượng từ yêu cầu sản phẩm
Nên bắt đầu từ hai tham số: số phần tử dự kiến n và tỷ lệ dương tính giả mục tiêu p. Số bit gần tối ưu:
m = -n ln(p) / (ln(2))²
k = (m / n) ln(2)| Tỷ lệ mục tiêu | Bit mỗi phần tử (xấp xỉ) | Số hash gần tối ưu |
|---|---|---|
| 1% | 9,6 bit | 7 |
| 0,1% | 14,4 bit | 10 |
| 0,01% | 19,2 bit | 14 |
Ví dụ, một triệu phần tử với mục tiêu 1% cần khoảng 9,6 triệu bit, tương đương gần 1,2 MB cho mảng bit, chưa tính metadata. Đừng chọn p chỉ vì nghe có vẻ nhỏ. Hãy quy đổi nó thành chi phí downstream: với 50 triệu truy vấn âm tính mỗi ngày, 1% có thể gây tới khoảng 500.000 lần kiểm tra thừa nếu workload phù hợp giả định.
5. Bloom filter không lưu khóa
Filter không thể liệt kê các phần tử đã thêm, trả lại giá trị gốc hay chứng minh phần tử nào đã bật một bit. Nó chỉ hỗ trợ phép kiểm tra membership gần đúng. Vì vậy, thiết kế thường có hai tầng:
- Bloom filter trả lời nhanh ở RAM hoặc gần nơi xử lý.
- Nguồn dữ liệu chuẩn—database, object store hoặc index chính xác—xác nhận các trường hợp “có thể có”.
Nếu filter trả về true và ứng dụng bỏ qua bước thứ hai, false positive có thể bị biến thành quyết định nghiệp vụ sai: bỏ qua tạo tài khoản, báo nhầm file tồn tại hoặc từ chối một request hợp lệ.
6. Tại sao không thể xóa bit trực tiếp?
Một bit có thể được nhiều phần tử cùng sử dụng. Xóa phần tử bằng cách đặt các bit của nó về 0 có thể xóa luôn dấu vết của phần tử khác và tạo false negative. Bloom filter chuẩn vì thế phù hợp với tập chỉ thêm hoặc vòng đời được quản lý bằng cách xây lại toàn bộ filter.
Counting Bloom filter thay bit bằng counter để hỗ trợ tăng/giảm, nhưng dùng nhiều bộ nhớ hơn và vẫn cần xử lý overflow, concurrency cùng thao tác xóa phần tử chưa tồn tại. Một lựa chọn khác là chia filter theo thời gian, giữ nhiều generation và loại bỏ trọn generation đã hết hạn.
7. Ứng dụng thực tế
- Cơ sở dữ liệu và LSM tree: tránh đọc SSTable chắc chắn không chứa khóa.
- Cache: chặn truy vấn cho khóa không tồn tại nhằm giảm cache penetration.
- Web crawler: sàng nhanh URL có thể đã thấy trước khi kiểm tra kho chính xác.
- Hệ phân tán: trao đổi bản tóm tắt tập khóa để giảm dữ liệu hoặc request không cần thiết.
- Phân phối nội dung: dự đoán node có thể giữ object nào trước khi gửi yêu cầu.
- Bảo mật: kiểm tra sơ bộ danh sách rò rỉ hoặc blocklist, nhưng phải có bước xác nhận phù hợp.
Bloom filter có lợi nhất khi đa số truy vấn là âm tính, phép kiểm tra phía sau đắt và hệ thống chấp nhận một lượng kiểm tra thừa. Nếu mọi truy vấn hầu như đều dương tính hoặc nguồn chính đã rất rẻ, filter có thể chỉ làm tăng độ phức tạp.
8. Vượt dung lượng làm filter xuống cấp
Dung lượng khai báo không phải giới hạn cứng ngăn insert. Nếu tiếp tục thêm vượt n, nhiều bit chuyển sang 1 và tỷ lệ false positive tăng nhanh. Filter vẫn trả lời, nhưng mục tiêu hiệu năng ban đầu không còn đúng.
Các chiến lược phổ biến gồm theo dõi tỷ lệ bit đã bật, ước lượng số phần tử, xây filter lớn hơn và swap nguyên tử, hoặc dùng scalable Bloom filter gồm nhiều filter con. Mỗi filter con làm tăng chi phí truy vấn; vì thế phải theo dõi latency và số tầng, không chỉ bộ nhớ.
9. Hash và serialization phải ổn định
Mọi producer và consumer phải biến một phần tử thành cùng chuỗi byte và cùng vị trí bit. Các khác biệt như chữ hoa/thường, Unicode normalization, byte order, version schema hoặc separator trường có thể tạo false negative ở cấp hệ thống dù thuật toán cục bộ đúng.
- Định nghĩa encoding và canonicalization rõ ràng.
- Ghi version của hash strategy, seed, số bit và số hash trong metadata.
- Không dùng hash mật mã nặng nếu threat model không cần; chọn hash nhanh, phân bố tốt.
- Với input do đối thủ kiểm soát, cân nhắc seed bí mật hoặc hash chống tấn công để tránh phân bố chủ ý.
- Kiểm tra tương thích trước khi merge hai filter; OR mảng bit chỉ hợp lệ khi toàn bộ tham số giống nhau.
10. Đồng thời, persistence và rollout
Trong môi trường đa luồng, thao tác set bit phải nguyên tử hoặc được đồng bộ; nếu update bị mất, filter có thể sinh false negative. Khi persist filter, cần snapshot nhất quán với dữ liệu mà nó đại diện. Một filter mới hơn database snapshot hoặc cũ hơn transaction log đều có thể phá vỡ giả định.
Rollout phiên bản hash mới nên dùng tên/epoch mới, dual-write trong giai đoạn chuyển đổi và chỉ chuyển read sau khi backfill hoàn tất. Nếu filter chỉ là optimization, có thể fail open về nguồn dữ liệu chuẩn khi file hỏng, metadata không khớp hoặc filter chưa sẵn sàng.
11. Quan sát và kiểm thử
- Test rằng mọi phần tử đã insert luôn trả về
true. - Sinh tập phần tử không giao nhau đủ lớn để đo false-positive rate với khoảng tin cậy phù hợp.
- Test cùng vector byte trên mọi ngôn ngữ và kiến trúc triển khai.
- Test serialize/deserialize, version mismatch và snapshot bị cắt cụt.
- Đo occupancy, số phần tử ước tính, tỷ lệ truy vấn âm/dương và số lần fallback.
- Cảnh báo khi dung lượng, occupancy hoặc false-positive rate quan sát vượt ngân sách.
Không thể đo false positive chỉ từ kết quả Bloom filter; cần đối chiếu với nguồn sự thật. Dashboard nên phân biệt “filter nói có” với “backend xác nhận có”, nếu không hệ thống sẽ che giấu mức độ bão hòa.
12. Khi nào nên chọn cấu trúc khác?
| Yêu cầu | Lựa chọn phù hợp hơn |
|---|---|
| Cần kết quả chính xác và liệt kê phần tử | Hash set, B-tree hoặc index chính xác |
| Cần xóa thường xuyên | Counting Bloom filter hoặc cấu trúc approximate khác có delete |
| Cần gắn giá trị với khóa | Hash map / key-value store |
| Tập nhỏ, backend rẻ | Có thể không cần lớp filter |
| Không chấp nhận false positive | Tra cứu chính xác; filter chỉ được dùng như optimization có xác nhận |
Checklist thiết kế
- Đã xác định số phần tử cực đại và tỷ lệ false positive theo SLO.
- Đã quy đổi false positive thành chi phí request/I/O thực tế.
- Đã cố định encoding, hash strategy, seed và version.
- Đã có kế hoạch rebuild, resize hoặc rotation khi filter đầy.
- Mọi kết quả “có thể có” đều được xác nhận khi nghiệp vụ yêu cầu chính xác.
- Concurrency và persistence không làm mất bit đã bật.
- Có metric đối chiếu filter với nguồn sự thật.
Tài liệu tham khảo
- Burton H. Bloom: Space/Time Trade-offs in Hash Coding with Allowable Errors
- Redis documentation: Bloom filter sizing and behavior
- Google Guava BloomFilter implementation and API contract
Kết luận
Bloom filter đổi một lượng dương tính giả có kiểm soát lấy bộ nhớ nhỏ và khả năng loại trừ rất nhanh. Giá trị lớn nhất của nó không nằm ở câu trả lời “có”, mà ở câu trả lời “chắc chắn không”. Một triển khai tốt phải coi filter là lớp tối ưu hóa trước nguồn dữ liệu chuẩn, sizing theo workload, theo dõi bão hòa và giữ hash/serialization ổn định. Khi semantics ấy được bảo toàn, Bloom filter có thể giảm đáng kể I/O và latency mà không làm sai nguồn sự thật.
Chưa có bình luận. Hãy là người đầu tiên chia sẻ ý kiến.