
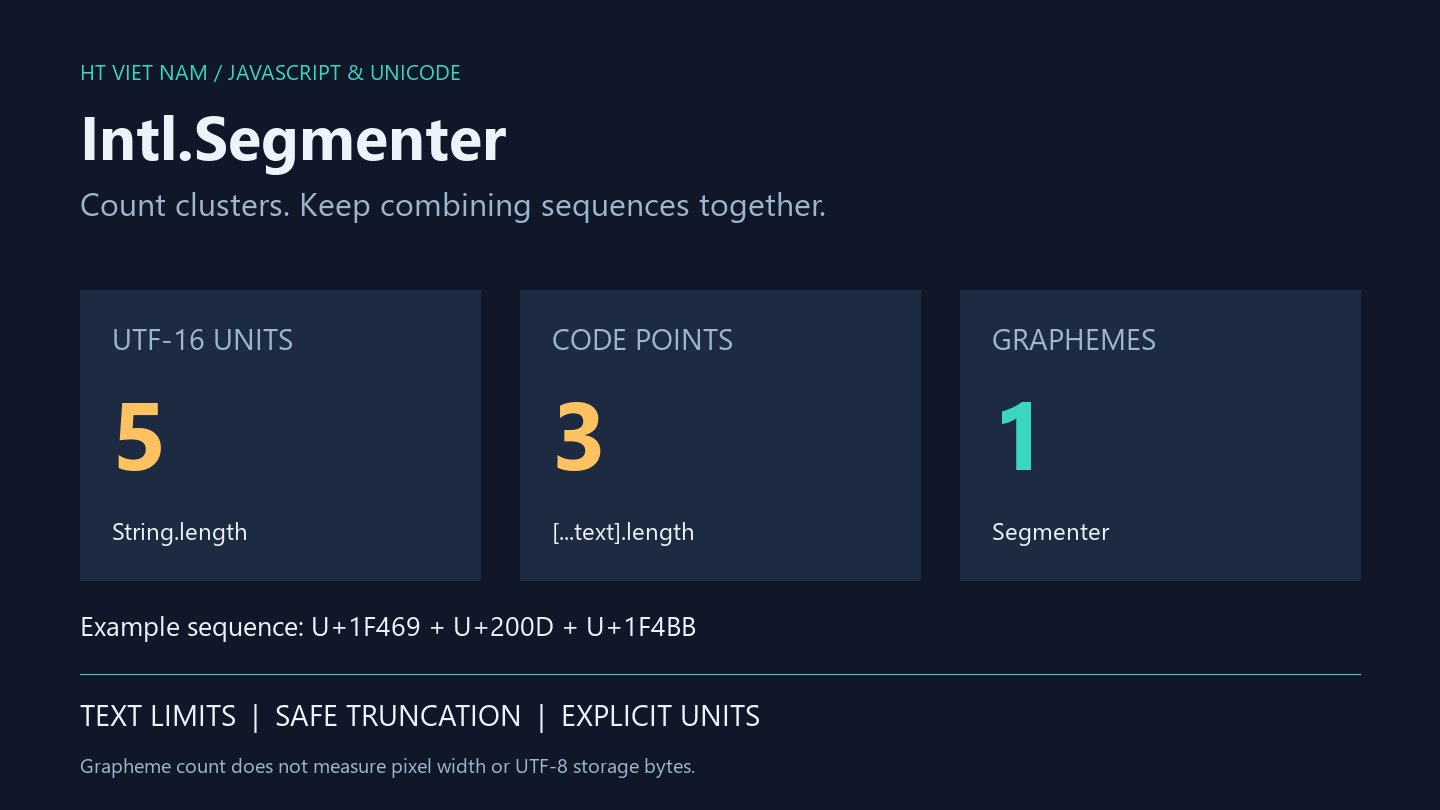
Bộ đếm báo một emoji có nhiều “ký tự”, còn đoạn mô tả bị cắt giữa dấu tiếng Việt hoặc chuỗi emoji. Nguyên nhân thường là ứng dụng đang dùng một đơn vị đo khác với điều người dùng nhìn thấy. JavaScript có nhiều cách duyệt chuỗi; mỗi cách phục vụ một mục đích.
Intl.Segmenter với granularity là grapheme giúp làm việc theo cụm ký tự. Đây là đơn vị hữu ích cho bộ đếm và cắt văn bản, nhưng không phải phép đo chiều rộng trên màn hình hay số byte lưu trữ.
1. Ba cách đếm có thể cho ba kết quả
const text = '\u{1F469}\u200D\u{1F4BB}'; // 👩💻
const segmenter = new Intl.Segmenter('vi', {
granularity: 'grapheme'
});
console.log(text.length); // 5
console.log([...text].length); // 3
console.log([...segmenter.segment(text)].length); // 1length đếm đơn vị mã UTF-16. Duyệt bằng spread đi theo code point, nhưng emoji trong ví dụ gồm nhiều code point nối với nhau. Segmenter nhận diện chúng thành một grapheme cluster trong môi trường kiểm tra.
Ví dụ dùng Unicode escape để giữ rõ dữ liệu khi sao chép qua editor. Một ảnh chụp emoji không đủ cho việc tái hiện lỗi; nên lưu mẫu đầu vào thực tế và cách biểu diễn của nó.
2. Dấu tổ hợp cũng thuộc cùng cụm
const text = 'a\u0306\u0301'; // ắ dạng tổ hợp
const segmenter = new Intl.Segmenter('vi', {
  granularity: 'grapheme'
});

console.log(text.length); // 3
console.log(text.slice(0, 1) === 'a'); // true
console.log([...segmenter.segment(text)][0].segment === text); // true
Cắt bằng slice(0, 1) giữ lại a nhưng bỏ các dấu theo sau. Duyệt theo cụm giữ phần chữ và dấu cùng nhau. Chuẩn hóa Unicode và phân đoạn là hai thao tác khác nhau: phân đoạn không tự chuyển chuỗi về NFC, cũng không làm hai biểu diễn có cùng byte.
3. Viết hàm cắt theo số cụm
Hàm dưới đây lấy tối đa limit cụm đầu, không thêm dấu ba chấm và không trim. Nó xử lý văn bản thuần, không nhận HTML để cắt thẻ.
const graphemes = new Intl.Segmenter('vi', {
granularity: 'grapheme'
});
function takeGraphemes(text, limit) {
if (typeof text !== 'string') {
throw new TypeError('Expected text');
}
if (!Number.isSafeInteger(limit) || limit < 0) {
throw new RangeError('Expected a non-negative safe integer');
}
if (limit === 0) return '';
let result = '';
let count = 0;
for (const part of graphemes.segment(text)) {
result += part.segment;
count += 1;
if (count === limit) break;
}
return result;
}
console.log(takeGraphemes('A👩💻B', 2)); // A👩💻
console.log(takeGraphemes('abc', 0)); // chuỗi rỗngVòng lặp dừng khi lấy đủ cụm, tránh tạo mảng chứa tất cả các cụm chỉ để lấy phần đầu. Đây không phải cam kết về độ phức tạp hay bộ nhớ của toàn bộ runtime; cần đo với payload thật nếu xử lý văn bản lớn.
Nếu giao diện thêm dấu ba chấm, hãy xác định dấu đó có tính vào hạn mức hay không và giữ cách đếm nhất quán. Với yêu cầu chỉ rút gọn hiển thị theo chiều rộng, cân nhắc CSS phù hợp thay vì thay đổi dữ liệu gốc.
4. index vẫn dùng tọa độ UTF-16
const segmenter = new Intl.Segmenter('vi', {
granularity: 'grapheme'
});
const text = 'A👩💻B';
const indices = [...segmenter.segment(text)].map(part => part.index);
console.log(indices.join(',')); // 0,1,6index cho vị trí bắt đầu trong chuỗi đầu vào, theo đơn vị mã UTF-16. Nó không phải số thứ tự cụm 0, 1, 2. Khi dùng vị trí để slice hoặc ánh xạ lựa chọn văn bản, cần ghi rõ hệ tọa độ đang dùng.
5. Đồng bộ giới hạn giữa các tầng
- Thông báo “tối đa 100 ký tự” cần nêu chính sách đếm mà sản phẩm áp dụng.
- Backend phải kiểm tra độc lập, đồng thời đáp ứng giới hạn byte hoặc cột lưu trữ.
- Không dùng số cụm để suy ra độ rộng pixel: font và cách hiển thị vẫn ảnh hưởng.
- Kiểm tra Intl.Segmenter tồn tại và locale được hỗ trợ trên runtime đích.
- Nếu cần fallback, dùng giải pháp phân đoạn được kiểm chứng; Array.from không tương đương grapheme segmentation.
Các phiên bản dữ liệu Unicode có thể khác nhau giữa runtime. Hãy thử tiếng Việt dạng dựng sẵn/tổ hợp, emoji nối ZWJ, cờ, màu da, chuỗi rỗng và xuống dòng ở cả client lẫn server.
Các đoạn code đã chạy bằng Node.js local. Chưa kiểm thử nhập liệu IME, vị trí con trỏ hay cách vẽ emoji trong trình duyệt. Tài liệu đối chiếu: Intl.Segmenter, segment() và String.length.
Chọn đúng đơn vị đo trước khi đặt giới hạn. Đếm theo cụm giúp thao tác với văn bản gần cách đọc hơn, còn byte, định danh và bố cục vẫn cần quy tắc riêng.




Chưa có bình luận. Hãy là người đầu tiên chia sẻ ý kiến.