
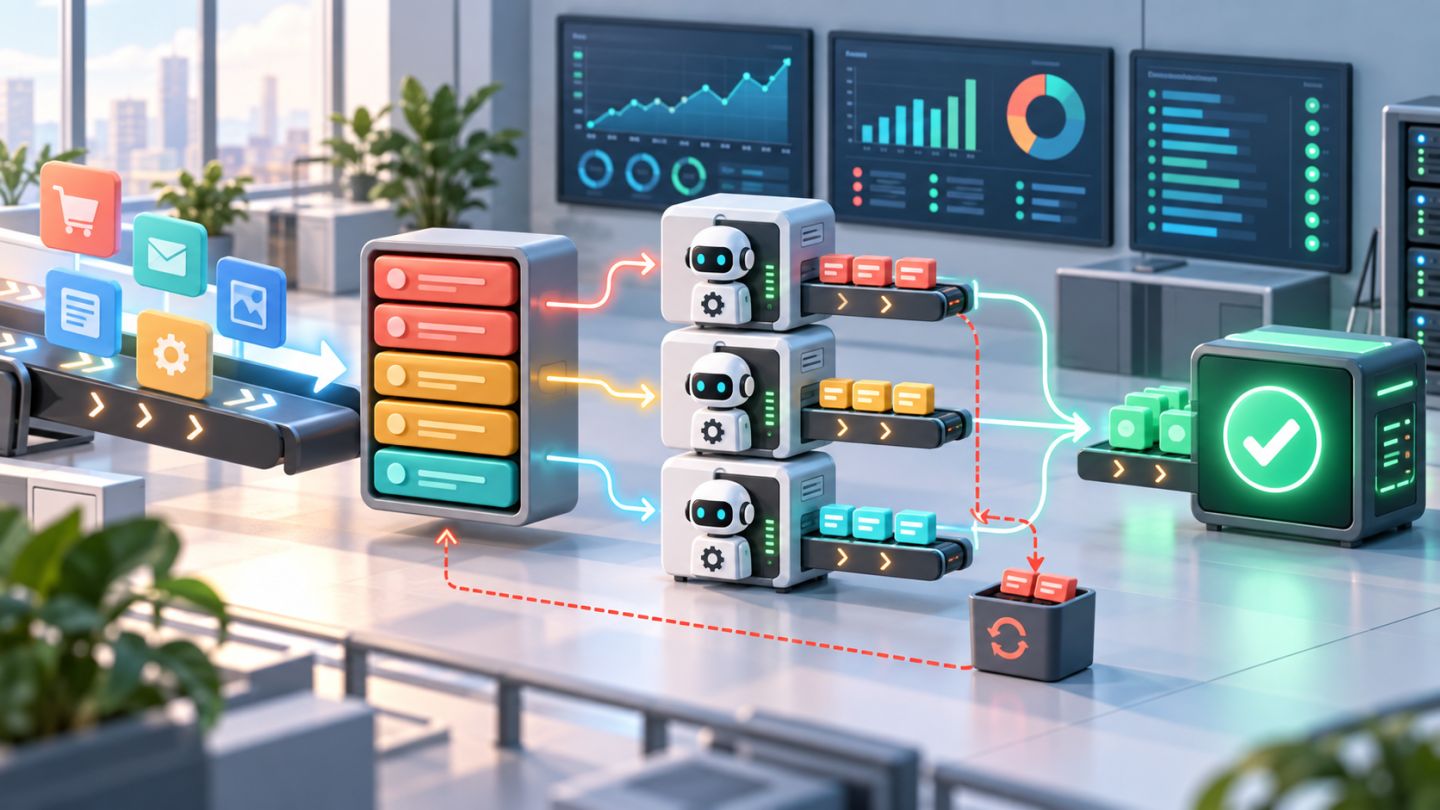
Đưa một tác vụ sang queue mới chỉ là bước đầu. Trên production, hệ thống còn phải đối mặt với worker bị dừng khi deploy, API bên thứ ba chập chờn, job chạy lại nhiều lần và hàng đợi tăng nhanh hơn khả năng xử lý. Một queue tốt không chỉ chạy được, mà còn phải thất bại có kiểm soát và phục hồi được.
Bài viết này trình bày cách thiết kế Laravel Queue theo hướng vận hành thực tế: payload gọn, job idempotent, retry có khoảng nghỉ, timeout hợp lý và có số liệu để phát hiện nghẽn trước khi người dùng phản ánh.
Queue giải quyết vấn đề gì?
Những việc như gửi email, tạo báo cáo, đồng bộ dữ liệu hoặc xử lý ảnh thường không cần hoàn thành trong request hiện tại. Đẩy chúng sang queue giúp request phản hồi nhanh hơn và cho phép worker xử lý độc lập.
Laravel phân biệt connection và queue. Connection là backend như Redis, Amazon SQS hoặc database; một connection có thể chứa nhiều queue để tách ưu tiên:
GenerateInvoice::dispatch($orderId)->onQueue('high');
SendCampaignEmail::dispatch($campaignId)->onQueue('bulk');

php artisan queue:work --queue=high,default,bulk
Thứ tự trong --queue thể hiện ưu tiên. Tuy nhiên, tác vụ bulk vẫn có thể bị đói tài nguyên nếu lưu lượng high liên tục; hệ thống lớn nên tách worker và giới hạn tài nguyên theo nhóm.
Chỉ đưa định danh vào payload
Payload càng lớn càng tốn băng thông, bộ nhớ và thời gian serialize. Thay vì truyền một cấu trúc dữ liệu đồ sộ, hãy truyền ID ổn định rồi đọc trạng thái mới nhất trong handle():
final class GenerateInvoice implements ShouldQueue
{
    use Queueable;

    public function __construct(public int $orderId) {}

    public function handle(InvoiceService $service): void
    {
        $order = Order::query()->findOrFail($this->orderId);
        $service->generateFor($order);
    }
}
Laravel chỉ serialize định danh khi truyền Eloquent model, nhưng relationship đã load có thể làm payload phình to và được truy vấn lại đầy đủ. Có thể dùng withoutRelations() hoặc chỉ truyền scalar ID để ý định rõ ràng hơn.
Job phải idempotent
Một job có thể được thực thi lại sau timeout, mất kết nối hoặc worker bị dừng đúng lúc kết quả đã được ghi nhưng ACK chưa hoàn tất. Vì vậy, handle() phải cho phép chạy lại mà không tạo hóa đơn, trừ tiền hoặc gửi thông báo trùng.
- Dùng khóa nghiệp vụ duy nhất như
order_id + document_type. - Kiểm tra trạng thái hoàn thành trước khi thực hiện side effect.
- Dùng unique constraint trong database làm lớp bảo vệ cuối.
- Gửi idempotency key khi gọi dịch vụ bên ngoài có hỗ trợ.
- Đặt cập nhật dữ liệu liên quan trong transaction phù hợp.
if (Invoice::query()->where('order_id', $this->orderId)->exists()) {
    return;
}

DB::transaction(function (): void {
    Invoice::query()->create(['order_id' => $this->orderId]);
});
Không nên coi ShouldBeUnique là thay thế cho idempotency. Khóa unique giúp hạn chế job trùng trong hàng đợi, nhưng không bảo vệ mọi tình huống lỗi giữa side effect và xác nhận hoàn tất.
Cấu hình retry, backoff và timeout
Retry ngay lập tức nhiều lần có thể làm API đang quá tải càng tệ hơn. Nên đặt số lần thử hữu hạn và tăng khoảng nghỉ:
public int $tries = 5;
public int $timeout = 120;
public bool $failOnTimeout = true;

public function backoff(): array
{
    return [10, 30, 120, 300];
}
timeout của worker phải ngắn hơn retry_after của connection. Nếu không, cùng một job có thể được phát lại trong khi tiến trình cũ vẫn đang chạy. Với HTTP client, luôn đặt connect timeout và request timeout riêng; đừng để worker chờ vô hạn.
Phân loại lỗi có thể thử lại
Không phải lỗi nào cũng nên retry. Timeout mạng, HTTP 429 hoặc 503 thường là lỗi tạm thời. Dữ liệu validation sai, bản ghi không tồn tại hoặc cấu hình thiếu thường cần fail sớm và cảnh báo.
public function handle(RemoteClient $client): void
{
    try {
        $client->sync($this->orderId);
    } catch (RateLimitException $e) {
        $this->release(60);
    }
}
Laravel có middleware cho rate limiting, chống job chạy chồng và throttling exception. Dùng middleware giúp chính sách retry thống nhất thay vì lặp logic trong nhiều job.
Dispatch sau khi transaction commit
Nếu job được dispatch bên trong transaction, worker nhanh có thể chạy trước khi dữ liệu được commit. Khi đó job không tìm thấy bản ghi hoặc đọc trạng thái cũ. Có thể bật after_commit cho connection hoặc chỉ định trên lần dispatch:
ProcessOrder::dispatch($order->id)->afterCommit();Worker là tiến trình sống lâu
queue:work giữ ứng dụng trong bộ nhớ nên không tự nhận code mới sau deploy. Quy trình deploy cần restart mềm:
php artisan queue:restartTrên server, Supervisor hoặc một process manager tương đương phải tự khởi động lại worker khi crash và sau reboot. Với Horizon, dùng php artisan horizon:terminate trong deployment để process manager dựng lại tiến trình bằng code mới.
Giám sát những chỉ số nào?
- Queue depth: số job đang chờ theo từng queue.
- Wait time: thời gian từ lúc dispatch đến lúc worker bắt đầu xử lý.
- Throughput: số job hoàn thành trong một khoảng thời gian.
- Failure rate: tỷ lệ job thất bại và nguyên nhân phổ biến.
- Runtime: thời gian xử lý p50, p95, p99 để phát hiện job chậm bất thường.
Laravel Horizon cung cấp dashboard và cấu hình worker cho queue Redis. Dù dùng Horizon hay công cụ khác, cảnh báo nên dựa trên wait time và failure rate thay vì chỉ kiểm tra process còn sống.
Quy trình xử lý failed job
- Đọc exception, input định danh và correlation ID; không log secret hoặc dữ liệu nhạy cảm.
- Xác định lỗi tạm thời hay lỗi dữ liệu/code.
- Sửa nguyên nhân trước khi retry hàng loạt.
- Retry một job đại diện và xác minh side effect không bị lặp.
- Chỉ sau đó mới dùng
queue:retrycho nhóm phù hợp. - Prune failed jobs theo chính sách lưu giữ để bảng không tăng vô hạn.
Checklist trước khi đưa queue lên production
- Job idempotent và có unique constraint khi cần.
- Payload nhỏ, không chứa secret hoặc binary lớn.
tries,backoff,timeoutvàretry_aftertương thích.- Dispatch sau commit nếu job phụ thuộc dữ liệu vừa ghi.
- Worker được quản lý, restart khi deploy và tự phục hồi khi crash.
- Có dashboard, cảnh báo wait time, failed jobs và runbook xử lý sự cố.




Chưa có bình luận. Hãy là người đầu tiên chia sẻ ý kiến.