
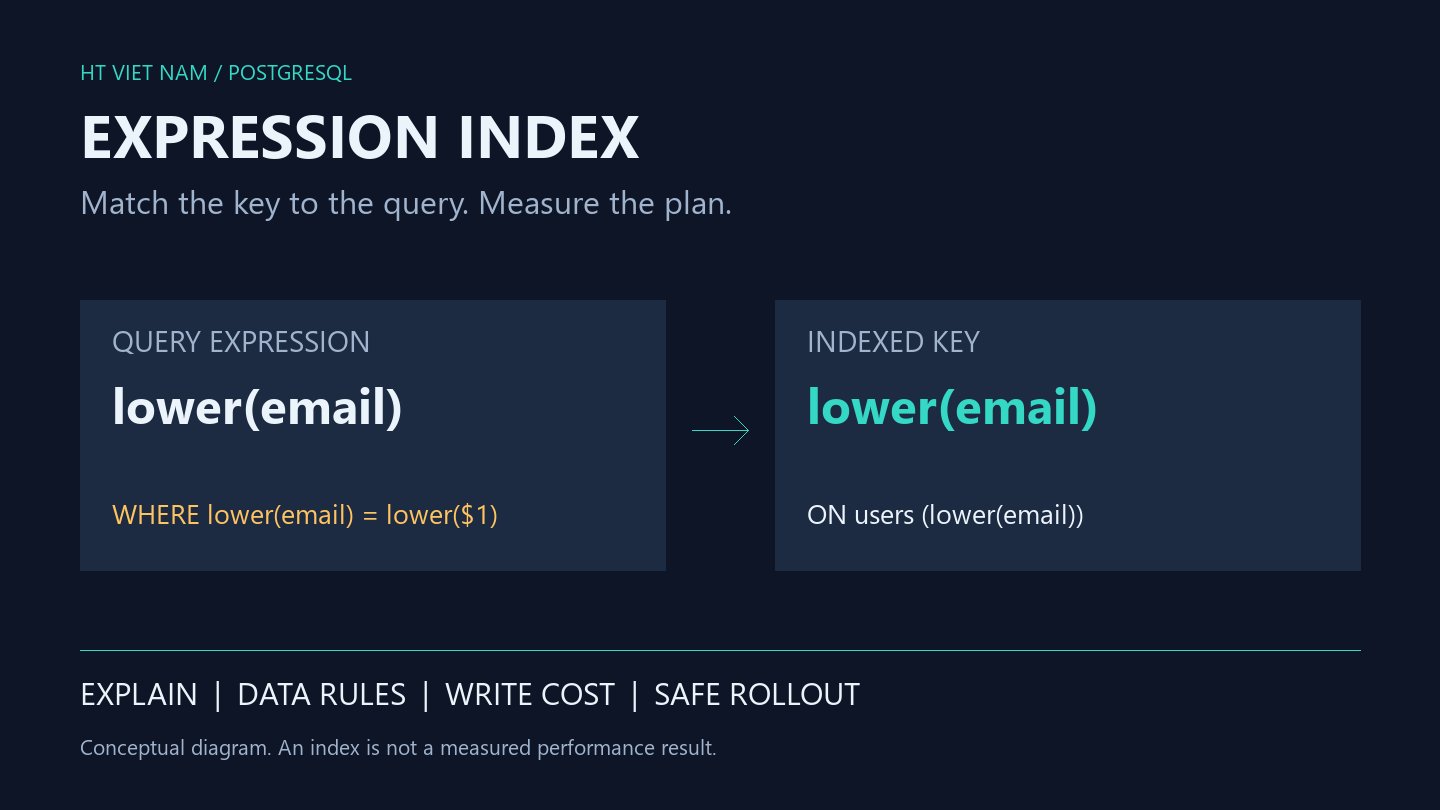
Đã tạo index trên email nhưng truy vấn tìm tài khoản vẫn chậm? Hãy nhìn vào biểu thức trong WHERE. Nếu ứng dụng tìm bằng lower(email), index trên giá trị email gốc không trực tiếp lưu khóa mà điều kiện này cần tra cứu.
Expression index lưu kết quả biểu thức làm khóa tìm kiếm. Bài viết dùng một bảng users giả định và quy tắc nghiệp vụ coi email không phân biệt hoa thường. SQL là ví dụ để thử trong database kiểm thử; không phải benchmark hay thay đổi đã thực hiện trên một hệ thống production.
1. Xác định đúng câu truy vấn cần tối ưu
Giả sử người dùng nhập email khác kiểu viết hoa so với dữ liệu đã lưu. Một truy vấn có thể được thiết kế như sau; ký hiệu $1 là tham số của prepared statement phía ứng dụng:
SELECT id, email
FROM users
WHERE lower(email) = lower($1);
Trước khi thêm index, ghi lại truy vấn thật từ ứng dụng: kiểu tham số, điều kiện tenant, giới hạn số dòng và cách so sánh. Một ví dụ rút gọn bỏ mất tenant_id có thể dẫn đến index không phù hợp với workload thực tế.
Theo tài liệu Indexes on Expressions, có thể tạo index trên lower(email). Đổi lại, việc duy trì index làm tăng chi phí ghi. Hãy đánh giá cả tốc độ tra cứu lẫn đường insert/update.
2. Tạo một index khớp với biểu thức
Trong database thử nghiệm với bảng users đã có sẵn:
CREATE INDEX users_email_lower_idx
ON users (lower(email));
Đây là index thường, không phải ràng buộc duy nhất. Hai hàng có email chỉ khác cách viết hoa vẫn có thể tồn tại. Nếu yêu cầu của sản phẩm chỉ là tìm kiếm, chưa nên tự thêm UNIQUE vì điều đó thay đổi dữ liệu nào được phép ghi.
Đừng suy luận rằng index này tối ưu mọi dạng tìm kiếm email. Truy vấn email ILIKE '%example%' tìm chuỗi con là một bài toán khác; index cho phép bằng lower(email) không phải bằng chứng truy vấn đó đã nhanh.
3. So sánh kế hoạch bằng EXPLAIN
Ở môi trường kiểm thử, lấy baseline trước khi tạo index và chạy lại cùng câu truy vấn sau khi tạo. Thay tham số bằng một giá trị có tính đại diện để dễ quan sát:
EXPLAIN (ANALYZE, BUFFERS)
SELECT id, email
FROM users
WHERE lower(email) = lower('Alice@example.com');
EXPLAIN ANALYZE thực sự chạy truy vấn. Cần đọc cùng số dòng thực tế, ước lượng và buffer, thay vì chỉ tìm tên node Index Scan. Planner có thể chọn Seq Scan hợp lý cho bảng nhỏ hoặc điều kiện trả nhiều hàng. Xem tài liệu Using EXPLAIN.
Một biên bản thử nghiệm hữu ích nên giữ cùng tập dữ liệu, tham số và cấu hình giữa hai lần đo. Ghi số lượng hàng, tỷ lệ email được tìm thấy, độ trễ nhiều lần chạy và ảnh hưởng cache nóng/lạnh. Không kết luận “nhanh hơn 100 lần” từ một lần đo trước/sau có điều kiện khác nhau.
4. Nếu cần duy nhất, kiểm tra dữ liệu trước
Với quy tắc sản phẩm đã được duyệt là email duy nhất sau khi chuyển về chữ thường, trước hết tìm các nhóm xung đột:
SELECT lower(email) AS email_key, count(*) AS total
FROM users
WHERE email IS NOT NULL
GROUP BY lower(email)
HAVING count(*) > 1;
Không tự xóa một tài khoản trong mỗi nhóm. Nhóm phụ trách phải quyết định quyền sở hữu, cách hợp nhất dữ liệu và thông báo người dùng. Kết quả audit sạch cũng không loại bỏ khả năng có bản ghi trùng mới được chèn trong thời gian chờ triển khai.
Sau khi xử lý dữ liệu và thống nhất contract, một index UNIQUE trên biểu thức sẽ kiểm soát giá trị được tính. Mặc định unique index coi các giá trị NULL là khác nhau; nếu email bắt buộc, cần thiết kế NOT NULL riêng. Với index ghép, tính duy nhất áp dụng cho cả bộ khóa. Xem Unique Indexes.
-- Chọn phương án này nếu cần uniqueness;
-- không tạo cả hai index giống nhau một cách máy móc.
CREATE UNIQUE INDEX users_email_lower_unique_idx
ON users (lower(email));
Ứng dụng phải chuyển lỗi trùng thành phản hồi rõ ràng. Chỉ kiểm tra “email đã tồn tại chưa?” rồi insert vẫn có race condition giữa các request đồng thời. Quy tắc cuối cùng cần được bảo vệ ở database.
5. Giữ quy tắc chuẩn hóa nhất quán
Trong bài này, không phân biệt hoa thường là lựa chọn nghiệp vụ cho tài khoản, không phải tuyên bố rằng mọi hệ thống email đều có cùng quy tắc. Cần thống nhất cách xử lý khoảng trắng, Unicode và collation trước khi gom các địa chỉ thành một khóa.
Nếu sản phẩm chọn lower(btrim(email)), hãy dùng biểu thức tương ứng trong cả index, truy vấn và audit trùng. Không để API chuẩn hóa một cách, background job chuẩn hóa cách khác và import dữ liệu bỏ qua quy tắc.
Với multi-tenant, hãy hỏi email cần duy nhất toàn hệ thống hay trong từng tenant. Ví dụ dưới đây là một thiết kế khác với unique toàn cục:
CREATE UNIQUE INDEX users_tenant_email_lower_unique_idx
ON users (tenant_id, lower(email));
Nếu tenant_id là thành phần bắt buộc của định danh, schema và luồng ghi phải thực thi điều đó. Câu SELECT vẫn cần scope tenant theo quyền đã xác thực; index không thay thế authorization.
6. Lập kế hoạch tạo index trên bảng đang hoạt động
CREATE INDEX yêu cầu các hàm dùng trong định nghĩa phải IMMUTABLE. Không đánh dấu một hàm tự viết là immutable chỉ để vượt lỗi nếu kết quả còn phụ thuộc thời gian hoặc dữ liệu bên ngoài.
Với bảng đang nhận ghi, có thể đánh giá CREATE INDEX CONCURRENTLY. Chế độ này có giới hạn: không chạy trong transaction block, có thêm công việc và có thể để lại index invalid khi lỗi. Nó không phải một thao tác miễn chi phí hoặc cam kết không ảnh hưởng dịch vụ.
-- Chạy độc lập, ngoài BEGIN/COMMIT, sau khi đã diễn tập.
CREATE INDEX CONCURRENTLY users_email_lower_idx
ON users (lower(email));
Đây là phương án thay cho CREATE INDEX thường ở phần thử nghiệm, không phải lệnh chạy tiếp sau khi index cùng tên đã tồn tại. Kiểm tra migration runner có tự bọc transaction hay không. Lên lịch quan sát I/O, dung lượng trống và ảnh hưởng ghi; xác nhận index hợp lệ trước khi công bố hoàn tất.
7. Checklist bàn giao
- Truy vấn thật, index và quy tắc chuẩn hóa dùng cùng contract.
- Có baseline và kế hoạch sau thay đổi trên dữ liệu đại diện.
- Đã kiểm thử giá trị hoa/thường, NULL, khoảng trắng và phạm vi tenant theo yêu cầu.
- Nếu dùng UNIQUE, có kế hoạch xử lý dữ liệu cũ và lỗi trùng từ các request đồng thời.
- Migration có phương án thực thi, theo dõi và xử lý thất bại đã được diễn tập.
- Không giữ nhiều index trùng chức năng mà chưa đánh giá lợi ích so với chi phí ghi.
Expression index hữu ích khi thao tác tra cứu thực sự dùng một biểu thức ổn định. Bắt đầu từ truy vấn, xác định quy tắc dữ liệu rồi đo kế hoạch thực thi sẽ đáng tin cậy hơn việc thêm index theo tên cột.




Chưa có bình luận. Hãy là người đầu tiên chia sẻ ý kiến.