
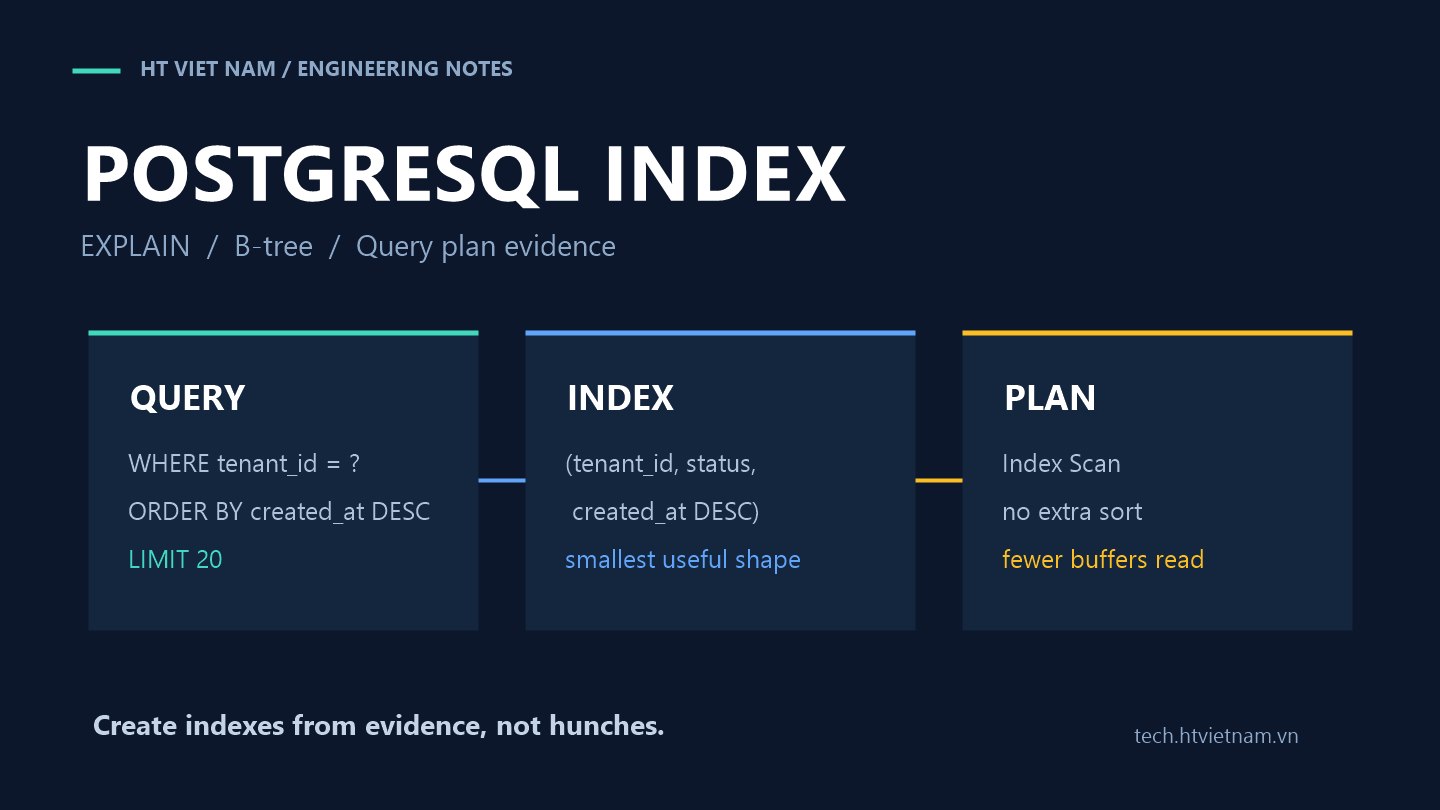
Index không phải nút “tăng tốc” có thể gắn bừa vào mọi cột. Một index đúng có thể biến truy vấn vài giây thành vài mili giây, nhưng index sai làm ghi dữ liệu chậm hơn, tốn RAM, phình storage và khiến planner có thêm lựa chọn nhiễu. Cách làm bền hơn là đọc query plan, hiểu điều kiện lọc, rồi tạo index phục vụ truy vấn thật.
1. Index giúp đọc nhanh nhưng làm ghi đắt hơn
Tài liệu PostgreSQL nhắc rất rõ: index giúp database tìm và lấy dòng nhanh hơn so với không có index, nhưng cũng thêm overhead cho toàn hệ thống, nên phải dùng hợp lý. Xem PostgreSQL Chapter 11: Indexes.
Mỗi lần insert, update hoặc delete, PostgreSQL không chỉ đổi dữ liệu trong table mà còn phải cập nhật index liên quan. Vì vậy, index nên xuất phát từ workload đọc quan trọng: endpoint nào chậm, query nào chạy nhiều, điều kiện lọc nào xuất hiện thường xuyên và bảng nào đang lớn lên nhanh.
2. B-tree là mặc định vì nó khớp nhiều truy vấn phổ biến
Mặc định, CREATE INDEX tạo B-tree index. B-tree phù hợp với so sánh bằng, khoảng giá trị, BETWEEN, IN, IS NULL, một số pattern LIKE 'abc%' và cả việc trả dữ liệu theo thứ tự. PostgreSQL mô tả các trường hợp này trong Index Types.
CREATE INDEX idx_orders_customer_id
ON orders (customer_id);
Index này hữu ích cho truy vấn như:
SELECT id, total_amount, created_at
FROM orders
WHERE customer_id = 42
ORDER BY created_at DESC
LIMIT 20;
Nhưng nếu truy vấn chính luôn lọc theo customer_id rồi sắp xếp theo created_at, một index đơn cột có thể chưa đủ tốt.
3. Multicolumn index phải đi theo thứ tự truy vấn
Với B-tree nhiều cột, PostgreSQL dùng hiệu quả nhất khi query có điều kiện trên cột bên trái đầu tiên. Tài liệu PostgreSQL nói rõ multicolumn B-tree index có thể dùng với subset các cột, nhưng hiệu quả nhất khi có ràng buộc trên leading columns. Xem Multicolumn Indexes.
CREATE INDEX idx_orders_customer_created
ON orders (customer_id, created_at DESC);
Index này khớp tốt với truy vấn lọc theo customer_id và lấy đơn mới nhất. Nó không hữu ích tương tự cho truy vấn chỉ lọc theo created_at, vì cột đầu tiên của index là customer_id.
Một quy tắc dễ nhớ: đặt cột equality quan trọng trước, rồi đến cột range hoặc sort. Với query WHERE tenant_id = ? AND status = ? AND created_at > ? ORDER BY created_at DESC, index (tenant_id, status, created_at DESC) thường đáng thử hơn index đặt created_at trước.
4. Dùng EXPLAIN để xem planner thật sự làm gì
Đừng chỉ nhìn query rồi đoán. Hãy dùng EXPLAIN hoặc EXPLAIN ANALYZE trên môi trường an toàn để xem PostgreSQL chọn sequential scan, index scan, bitmap scan hay sort. Tài liệu về kiểm tra index usage khuyến nghị xem index usage bằng EXPLAIN cho từng truy vấn và kiểm tra thống kê sử dụng index ở server đang chạy. Xem Examining Index Usage.
EXPLAIN (ANALYZE, BUFFERS)
SELECT id, total_amount, created_at
FROM orders
WHERE customer_id = 42
ORDER BY created_at DESC
LIMIT 20;
Những dấu hiệu cần chú ý gồm số dòng ước lượng so với số dòng thực tế, thời gian ở từng node, có sort riêng hay không, số block đọc từ shared buffers và index có được dùng đúng như kỳ vọng không. Nếu ước lượng sai quá xa, vấn đề có thể nằm ở thống kê chứ chưa chắc nằm ở thiếu index.
5. ANALYZE giúp planner có dữ liệu để quyết định
Planner cần thống kê phân bố dữ liệu để ước lượng số dòng. PostgreSQL ANALYZE thu thập thống kê nội dung table và lưu vào catalog để planner chọn execution plan hiệu quả. Xem ANALYZE.
Sau khi import lượng dữ liệu lớn, đổi phân bố dữ liệu hoặc tạo index mới trong môi trường thử nghiệm, hãy đảm bảo thống kê đã cập nhật. Nếu không, planner có thể vẫn chọn plan cũ vì nó tin rằng bảng nhỏ hơn, giá trị ít lệch hơn hoặc điều kiện lọc kém chọn lọc hơn thực tế.
6. Partial index rất hợp với dữ liệu có trạng thái
Nhiều bảng có một phần dữ liệu nóng và một phần dữ liệu lạnh. Ví dụ ứng dụng chỉ thường xuyên truy vấn đơn hàng đang mở:
CREATE INDEX idx_orders_open_by_tenant
ON orders (tenant_id, created_at DESC)
WHERE status IN ('pending', 'processing');
Index này nhỏ hơn index toàn bảng và tập trung vào truy vấn quan trọng. Nó không giúp truy vấn đơn đã hoàn tất, nhưng đó chính là điểm tốt nếu workload thật chủ yếu nằm ở đơn đang xử lý.
Partial index cần điều kiện query khớp được predicate của index. Nếu code lúc thì dùng status = 'pending', lúc thì dùng danh sách trạng thái khác, hãy kiểm tra plan thật để chắc planner có dùng index.
7. Covering index có thể giảm lượt đọc table
Nếu query chỉ cần vài cột ngoài cột lọc, INCLUDE có thể giúp index-only scan trong điều kiện phù hợp:
CREATE INDEX idx_orders_lookup
ON orders (tenant_id, customer_id, created_at DESC)
INCLUDE (total_amount, status);
Các cột INCLUDE không tham gia thứ tự tìm kiếm chính như key columns, nhưng có thể nằm sẵn trong index để giảm việc quay lại table lấy dữ liệu. Đừng đưa quá nhiều cột vào INCLUDE; index càng lớn càng tốn bộ nhớ, cache và chi phí ghi.
8. Một checklist trước khi tạo index mới
- Xác định query thật từ log, APM hoặc slow query report.
- Chạy
EXPLAIN (ANALYZE, BUFFERS)trên dữ liệu gần production. - Ghi lại điều kiện equality, range, sort và limit.
- Tạo index nhỏ nhất phục vụ truy vấn quan trọng nhất.
- Chạy lại EXPLAIN, so thời gian, row estimate, sort và buffer usage.
- Kiểm tra chi phí ghi, kích thước index và index có bị trùng với index cũ không.
- Theo dõi sau deploy bằng thống kê index usage và latency endpoint.
Index tốt không đến từ việc “cột này có vẻ hay lọc”. Nó đến từ việc hiểu query cụ thể, dữ liệu cụ thể và plan cụ thể. Khi đội backend dùng query plan làm căn cứ, việc tối ưu database bớt giống đoán mò và trở thành một vòng lặp đo đạc có thể lặp lại.




Chưa có bình luận. Hãy là người đầu tiên chia sẻ ý kiến.