
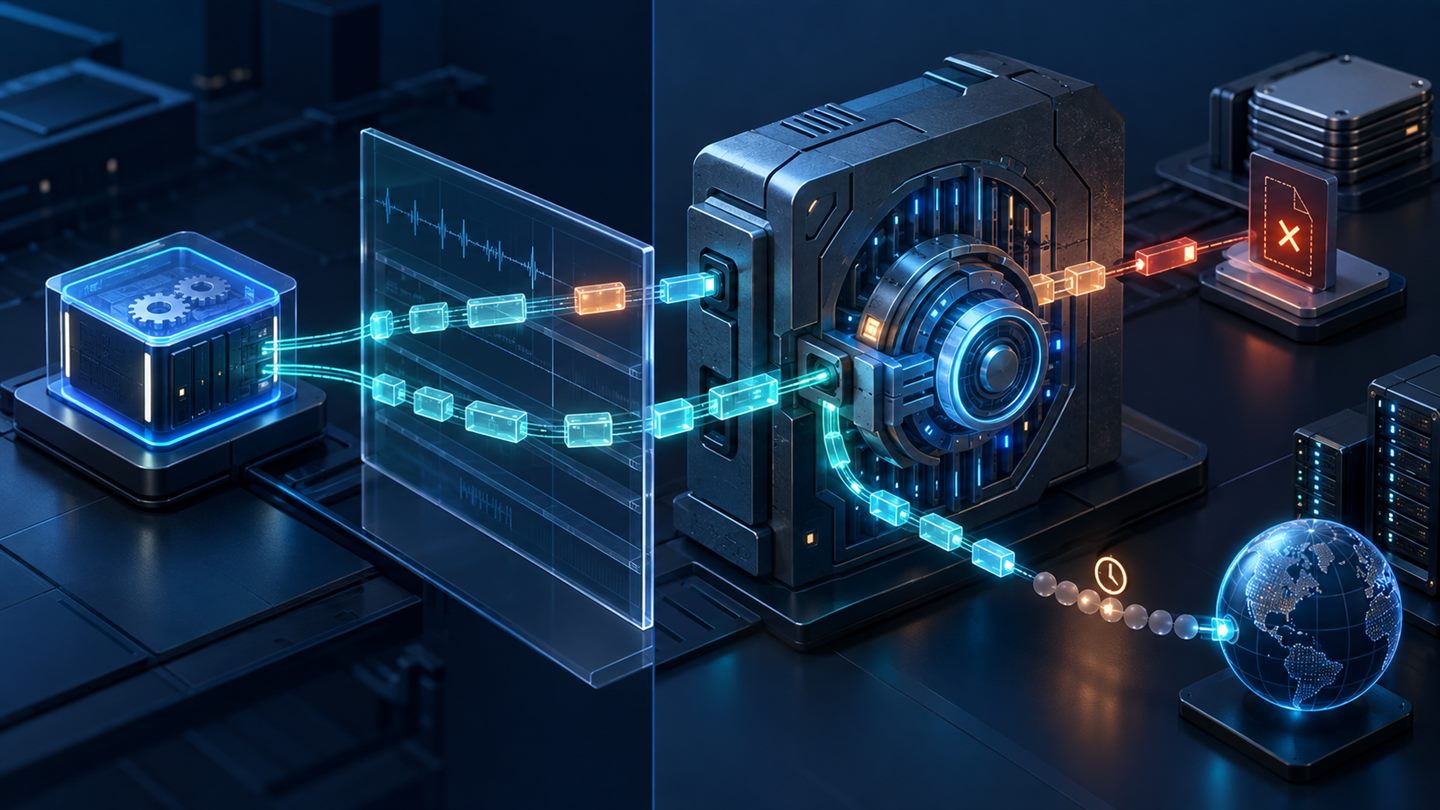
Khi một chương trình báo lỗi chung chung, treo không rõ nguyên nhân hoặc không tìm thấy file cấu hình, strace cho biết nó thực sự yêu cầu kernel làm gì. Công cụ ghi lại system call, đối số, giá trị trả về và signal tại ranh giới user space–kernel mà không cần biên dịch lại ứng dụng.
Giá trị của strace không nằm ở việc thu mọi syscall rồi đọc hàng nghìn dòng. Quy trình hiệu quả là đặt một giả thuyết, chọn đúng PID, giới hạn thời gian, lọc nhóm syscall liên quan và giải thích errno trong bối cảnh ứng dụng.
1. strace nhìn thấy gì và không thấy gì?
strace quan sát các tương tác với kernel như mở file, đọc/ghi, tạo process, kết nối socket, chờ event và nhận signal. Một dòng cơ bản có dạng:
openat(AT_FDCWD, "/etc/myapp/config.yaml", O_RDONLY) = -1 ENOENT (No such file or directory)Bên trái là tên syscall và đối số; bên phải là kết quả. Giá trị -1 đi cùng errno cho biết lời gọi thất bại. Khi thành công, openat thường trả về một file descriptor không âm.
strace không giải thích thuật toán nội bộ chạy hoàn toàn trong user space, không thay debugger mã nguồn và không tự chứng minh nguyên nhân gốc. Nó cung cấp bằng chứng ở ranh giới kernel để kiểm tra giả thuyết.
Một syscall thất bại chưa chắc là lỗi ứng dụng. Chương trình thường thử nhiều đường dẫn hoặc cơ chế rồi fallback thành công.
2. Bắt đầu bằng phiên bản và phạm vi
strace --version
strace -h | less
Tùy chọn có thể khác giữa phiên bản và distribution. Trước khi chạy trên production, xác định:
- Command hoặc PID nào cần quan sát.
- Khoảng thời gian đủ để tái hiện vấn đề.
- Nhóm nghi vấn: file, network, process, signal hay thời gian chờ.
- Nơi lưu trace có dung lượng, permission và retention phù hợp.
- Dữ liệu nhạy cảm nào có thể xuất hiện trong đối số hoặc buffer.
3. Trace một command mới
Cách an toàn nhất để học là cho strace khởi chạy command:
strace -o /tmp/myapp.trace -tt -T -s 256 -- ./myapp --config /etc/myapp/config.yaml| Tùy chọn | Ý nghĩa |
|---|---|
-o file | Ghi trace ra file thay vì trộn với output ứng dụng |
-tt | Thêm timestamp độ phân giải microsecond |
-T | Hiển thị thời gian nằm trong mỗi syscall |
-s 256 | Tăng độ dài chuỗi được in; cân nhắc rò dữ liệu |
-- | Kết thúc tùy chọn của strace trước command đích |
Nếu chỉ cần xem tương tác mà không giữ file, có thể bỏ -o; tuy nhiên trace và stderr của ứng dụng dễ lẫn nhau.
4. Attach vào tiến trình đang chạy
sudo strace -p 12345 -o /tmp/app-12345.trace -tt -T -s 128Nhấn Ctrl+C thường dừng tracer và để tracee tiếp tục. Attach cần permission phù hợp; chạy cùng UID chưa chắc đủ nếu Yama, capability, namespace hoặc trạng thái dumpable hạn chế ptrace.
Trên production, attach có thể làm thay đổi timing và tăng overhead, đặc biệt với process có syscall rate cao. Hãy bắt đầu bằng cửa sổ ngắn:
timeout 15s sudo strace -p 12345 -o /tmp/app-12345.trace -tt -TGiữ công cụ giám sát khác để quan sát latency, CPU và error rate trong lúc trace. Không mặc định strace là “chỉ đọc và không ảnh hưởng”.
5. Theo dõi process con và thread
Ứng dụng có thể fork worker hoặc exec chương trình khác. -f theo các process/thread được tạo:
strace -f -o /tmp/job.trace -tt -T -- ./run-jobVới -ff và -o, strace tách output theo PID, hữu ích khi trace hợp nhất quá khó đọc:
strace -ff -o /tmp/job.trace -tt -- ./run-jobCác file sẽ có hậu tố PID. Đổi lại, số lượng file có thể tăng mạnh; cần thư mục riêng, giới hạn thời gian và dọn theo chính sách.
6. Lọc syscall thay vì thu tất cả
Nhóm lọc giúp giảm nhiễu và overhead:
strace -e trace=%file -- ./myapp
strace -e trace=%network -- curl https://example.com
strace -e trace=%process -- ./worker
strace -e trace=read,write,close -p 12345
%file bao phủ các syscall nhận pathname, tránh bỏ sót biến thể như newfstatat. %network tập trung vào socket và network. Khi dùng cú pháp mới như -e status=failed, kiểm tra phiên bản cài đặt:
strace -e trace=%file -e status=failed -- ./myappLọc chỉ lỗi rất tiện để định hướng, nhưng có thể che mất lần thử thành công sau đó. Luôn quay lại một cửa sổ đầy đủ quanh sự kiện quan trọng.
7. Chẩn đoán lỗi file và permission
strace -f -e trace=%file -e status=failed -o /tmp/files.trace -- ./myappNhững errno thường gặp:
| Errno | Diễn giải ban đầu | Điều cần kiểm tra |
|---|---|---|
ENOENT | Path hoặc thành phần path không tồn tại | Working directory, chroot, mount, tên file, fallback |
EACCES | Không đủ quyền truy cập | Mode, owner, ACL, quyền search trên directory, LSM |
EROFS | Filesystem read-only | Mount flags, container rootfs, lỗi storage |
EMFILE | Process chạm giới hạn descriptor | /proc/PID/limits, rò FD, pool |
Đừng sửa mọi ENOENT. Dynamic loader, locale và thư viện có thể dò nhiều vị trí. Tìm chuỗi: chương trình dò gì, có fallback thành công không, và lỗi cuối có khớp triệu chứng không.
8. Chẩn đoán kết nối mạng
strace -f -e trace=%network -yy -tt -T -o /tmp/net.trace -- ./client-yy bổ sung thông tin gắn với file descriptor, giúp liên hệ socket với endpoint khi phiên bản hỗ trợ. Các dấu hiệu đáng chú ý:
ECONNREFUSED: endpoint trả lời nhưng không chấp nhận kết nối, thường do không có listener hoặc policy chủ động reject.ETIMEDOUT: cần đối chiếu route, firewall, packet loss và timeout của ứng dụng.EACCES/EPERM: có thể liên quan permission, firewall hoặc LSM.EINPROGRESS: bình thường với socket nonblocking; xem chuỗipoll/epoll_waitvà kết quả sau đó.
strace cho thấy ứng dụng gọi gì và kernel trả gì, nhưng không thay packet capture, DNS tooling, routing table hay log firewall.
9. Tiến trình “treo” đang chờ gì?
Attach ngắn thường cho biết process đang lặp, ngủ hay chờ:
timeout 10s sudo strace -p 12345 -tt -T -o /tmp/hang.tracefutex: có thể đang chờ lock/condition; cần stack trace và thread analysis để biết ai giữ lock.epoll_wait,poll,select: có thể là event loop nhàn rỗi hoàn toàn bình thường.readkéo dài: có thể chờ pipe, socket, terminal hoặc thiết bị.nanosleep: có thể retry/backoff theo thiết kế.
-T đo thời gian syscall theo góc nhìn trace, nhưng tracing cũng gây nhiễu. Không kết luận deadlock chỉ vì thấy futex.
10. Đọc unfinished và resumed
Trong chương trình nhiều thread, một syscall có thể bị xen bởi event từ thread khác:
[pid 2101] read(7,  <unfinished ...>
[pid 2102] write(9, "ok", 2) = 2
[pid 2101] <... read resumed>"data", 4) = 4
Hai dòng unfinished/resumed là một syscall, không phải hai lần gọi. Dùng PID/TID và timestamp để ghép đúng luồng.
11. Thống kê nhanh với -c
strace -f -c -- ./myapp-c tổng hợp số lần gọi, lỗi và thời gian theo syscall. Nó hữu ích để biết workload đang tập trung vào nhóm nào, nhưng không chỉ ra đối số hay trình tự gây lỗi. Tỷ lệ cao ở một syscall không tự động đồng nghĩa tối ưu syscall đó sẽ cải thiện toàn ứng dụng.
Đối với process production, chạy thống kê trong cửa sổ giới hạn và so sánh với baseline tương đương. Sampling profiler hoặc eBPF có thể phù hợp hơn nếu mục tiêu là profiling rộng với overhead thấp hơn.
12. Bảo vệ dữ liệu trong trace
Trace có thể chứa đường dẫn nội bộ, argument, biến liên quan tiến trình, hostname, địa chỉ mạng, nội dung buffer, token hoặc dữ liệu khách hàng. Hãy:
- Ghi vào file chỉ người chẩn đoán đọc được, ví dụ tạo thư mục mode
0700. - Không tăng
-shoặc dump buffer nếu không cần. - Không đính kèm trace thô vào ticket công khai.
- Redact có kiểm chứng trước khi chia sẻ.
- Đặt retention ngắn và xóa theo quy trình dữ liệu nhạy cảm.
- Không dùng fault injection/tampering của strace trên production nếu không có thử nghiệm được phê duyệt.
13. Permission, Yama và container
strace dựa trên ptrace. Linux còn kiểm tra UID, capability, user namespace, trạng thái dumpable và chính sách LSM. Yama ptrace_scope có thể chỉ cho phép quan hệ parent–child, yêu cầu CAP_SYS_PTRACE hoặc cấm attach.
cat /proc/sys/kernel/yama/ptrace_scopeKhông hạ ptrace_scope toàn hệ thống chỉ để tiện chẩn đoán. Ưu tiên chạy command dưới tracer ngay từ đầu, dùng quyền tối thiểu được phê duyệt hoặc quy trình debug container/node đã thiết kế sẵn.
Trong container, PID nhìn bên trong có thể khác host PID; capability và seccomp cũng có thể chặn attach. Xác định đúng namespace và không cấp container quyền đặc biệt lâu hơn phiên chẩn đoán.
14. Quy trình điều tra thực tế
- Ghi triệu chứng, thời điểm, request hoặc workload tái hiện.
- Xác định đúng executable, PID/TID và namespace.
- Chọn một giả thuyết: file, network, process lifecycle hay wait.
- Đặt giới hạn thời gian, output file và permission.
- Bắt đầu với filter hẹp; chỉ thêm
-f, chuỗi dài hoặc nhóm syscall khi cần. - Tìm errno, syscall chậm và chuỗi fallback—không grep một dòng rồi kết luận.
- Đối chiếu với application log, metrics, config, mount và network evidence.
- Dừng trace, kiểm tra tracee vẫn khỏe và bảo vệ artifact.
- Sửa nguyên nhân, tái hiện lại và xác nhận chuỗi syscall đã thay đổi như dự kiến.
Tài liệu tham khảo
Kết luận
strace biến câu hỏi “ứng dụng đang làm gì?” thành bằng chứng cụ thể tại ranh giới kernel: path nào được mở, endpoint nào được kết nối, errno nào được trả về và syscall nào đang chờ. Muốn dùng hiệu quả, hãy trace ngắn, lọc đúng giả thuyết, đọc cả chuỗi sự kiện và bảo vệ output. Đây là kính hiển vi chẩn đoán, không phải câu trả lời tự động cho mọi sự cố.
Chưa có bình luận. Hãy là người đầu tiên chia sẻ ý kiến.