
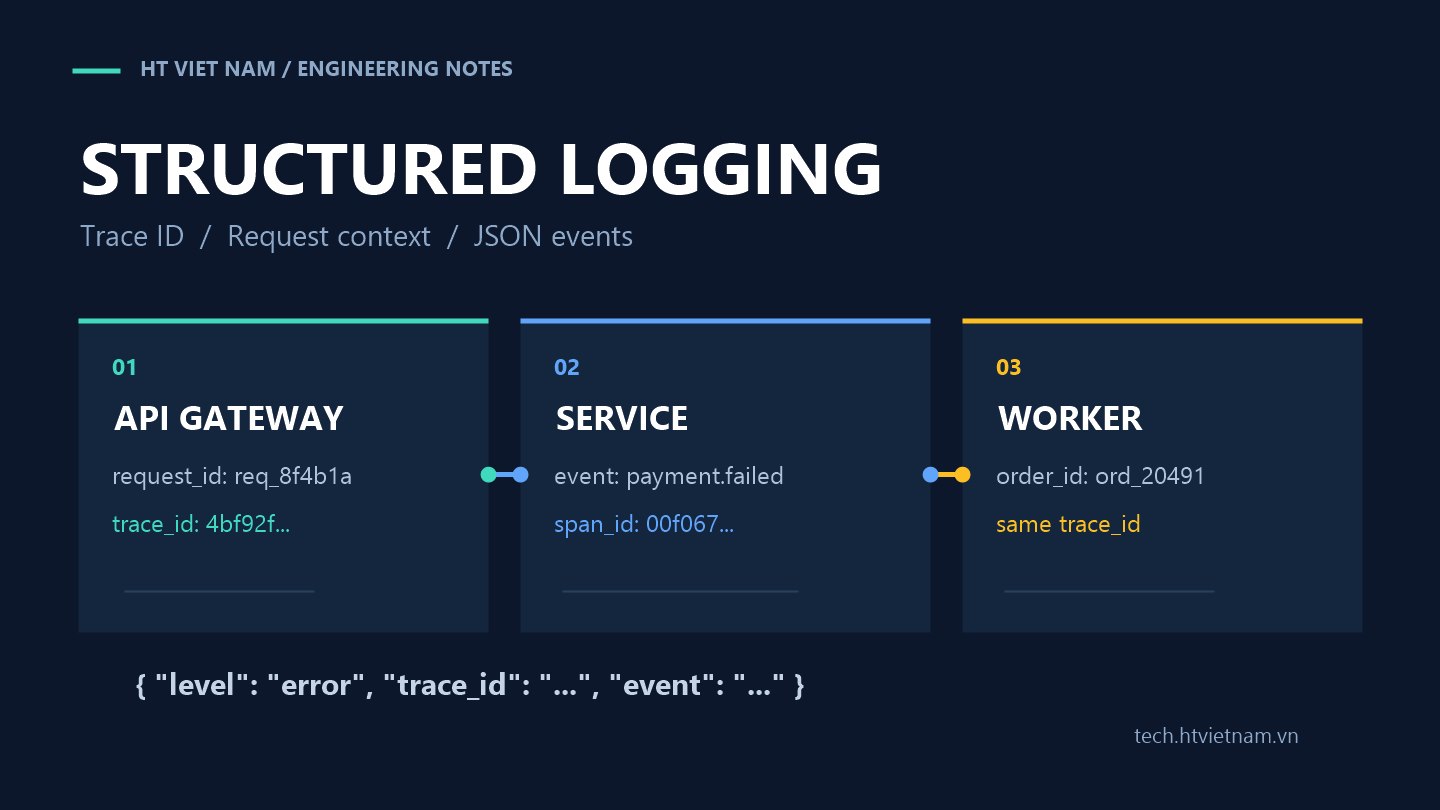
Khi hệ thống nhỏ, một dòng log dạng chữ tự do vẫn đủ để đoán chuyện gì vừa xảy ra. Khi ứng dụng có queue, API gateway, worker nền và nhiều service, kiểu log đó nhanh chóng trở thành mớ tiếng ồn. Structured logging giải quyết vấn đề bằng cách ghi log dưới dạng trường có tên, để người vận hành có thể lọc theo request, người dùng, endpoint, tenant hoặc trace thay vì đọc từng dòng bằng mắt.
1. Log tốt phải trả lời được câu hỏi điều tra
Một dòng như payment failed chỉ nói rằng có lỗi. Một bản ghi có cấu trúc nói thêm lỗi thuộc request nào, xảy ra ở service nào, user nào bị ảnh hưởng, thao tác nào đang chạy và downstream nào trả lỗi. Mục tiêu không phải ghi thật nhiều, mà là ghi đủ ngữ cảnh để tái dựng đường đi của một sự kiện.
OpenTelemetry định nghĩa log record gồm những trường như timestamp, severity, body, resource, attributes, TraceId và SpanId. Tài liệu chính thức mô tả mục tiêu của mô hình này là tạo cách hiểu chung về log record để hệ thống lưu trữ và phân tích có thể diễn giải nhất quán. Xem OpenTelemetry Logs Data Model.
2. Trace ID là sợi chỉ nối nhiều log
Trong một request đi qua nhiều thành phần, trace ID giúp gom các sự kiện thuộc cùng một luồng xử lý. API nhận request, service gọi database, worker phát webhook và cache bị miss có thể nằm ở các máy khác nhau, nhưng nếu cùng mang một trace ID, đội kỹ thuật có thể tìm được toàn bộ chuỗi liên quan.
OpenTelemetry cũng nhấn mạnh log correlation: log có thể liên kết với trace và metric theo thời gian, theo execution context như trace/span ID, và theo resource tạo ra telemetry. Xem OpenTelemetry Logging.
{
  "timestamp": "2026-09-21T09:14:32.418Z",
  "level": "error",
  "service": "checkout-api",
  "event": "payment.authorization_failed",
  "trace_id": "4bf92f3577b34da6a3ce929d0e0e4736",
  "span_id": "00f067aa0ba902b7",
  "request_id": "req_8f4b1a",
  "order_id": "ord_20491",
  "payment_provider": "stripe",
  "error_code": "card_declined"
}
Trong Elastic Common Schema, các trường tracing phổ biến là trace.id, span.id và transaction.id. Dù dùng tên trường nào, hãy chọn một quy ước và giữ ổn định trên mọi service. Xem Elastic ECS tracing fields.
3. Phân biệt trace ID, span ID và request ID
Trace ID đại diện cho cả luồng xử lý phân tán. Span ID đại diện cho một đoạn công việc nhỏ trong trace, ví dụ gọi Redis hoặc gửi email. Request ID thường là mã do gateway hoặc ứng dụng tạo cho một HTTP request cụ thể. Ba giá trị này có thể cùng xuất hiện, nhưng đừng dùng lẫn nghĩa.
Request ID hữu ích khi hệ thống chưa có tracing đầy đủ hoặc khi cần đối chiếu log của reverse proxy. Trace ID mạnh hơn trong hệ thống nhiều bước vì nó đi cùng context qua các service. Với job nền, hãy truyền tiếp trace context hoặc tối thiểu ghi lại ID nghiệp vụ như order_id, invoice_id hoặc message_id.
4. Chọn bộ trường nhỏ nhưng bền
Một schema thực tế nên bắt đầu từ các trường dùng nhiều nhất khi xử lý sự cố:
timestamp,level,service,environmenteventhoặcmessagecó tên ổn định, dễ lọctrace_id,span_id,request_idnếu có- ID nghiệp vụ như
user_id,tenant_id,order_id - Thông tin lỗi như
error.type,error.message,error.stack - Độ trễ và phụ thuộc ngoài như
duration_ms,db.statement_hash,http.status_code
Tránh đặt mọi thứ vào một chuỗi dài. Nếu cần lọc “mọi request 500 của tenant A gọi endpoint B trong 15 phút qua”, mỗi điều kiện nên là một trường riêng. Nếu trường là số, hãy ghi kiểu số; nếu là boolean, hãy ghi boolean. Đừng để hệ thống phân tích phải đoán kiểu dữ liệu từ chuỗi.
5. Không ghi bí mật vào log
Structured logging làm log dễ tìm hơn, vì vậy rò rỉ cũng dễ lan hơn. Không ghi password, token, session cookie, mã OTP, private key, số thẻ đầy đủ hoặc dữ liệu cá nhân không cần thiết. Nếu cần đối chiếu, dùng ID nội bộ, hash một chiều có salt phù hợp, hoặc phiên bản đã che bớt.
OWASP khuyến nghị application logging phải nhất quán và đặc biệt hữu ích cho sự kiện bảo mật, nhưng log cũng cần được thiết kế để quản lý, phân tích và bảo vệ đúng cách. Xem OWASP Logging Cheat Sheet.
6. Thiết kế event name như API nội bộ
Đừng để event name thay đổi theo câu văn. user.login.failed tốt hơn User failed to login because password is wrong vì nó ổn định để dashboard, alert và truy vấn dựa vào. Phần mô tả chi tiết có thể nằm ở trường reason, error_code hoặc message.
{
  "level": "warn",
  "service": "identity-api",
  "event": "user.login.failed",
  "trace_id": "2c5db8b7409f4e4d99c1a0fd0f2e3341",
  "request_id": "req_9d12c7",
  "user_id": "usr_183",
  "reason": "invalid_password",
  "ip_hash": "ip_7f61"
}
Khi event name đã ổn định, đội vận hành có thể đếm số lần thất bại, phát hiện tăng đột biến, hoặc drill down theo user mà không phải parse câu tiếng Việt, tiếng Anh hoặc chuỗi lỗi từ thư viện.
7. Gắn ngữ cảnh ở rìa hệ thống
Nơi tốt nhất để tạo request ID, đọc traceparent và thêm context thường là middleware ở rìa service. Từ đó, logger trong toàn bộ request có thể tự động gắn các trường chung. Lập trình viên không phải truyền từng ID qua mọi hàm, và log trong nhánh lỗi vẫn có đủ ngữ cảnh.
Với queue, hãy đưa context cần thiết vào metadata của message. Worker nhận job rồi khôi phục context trước khi ghi log. Nếu không làm bước này, request chính và xử lý nền sẽ tách rời nhau, đúng lúc bạn cần điều tra nhất.
8. Một lộ trình triển khai ít rủi ro
- Chuẩn hóa logger xuất JSON ở một service có lưu lượng thật nhưng rủi ro thấp.
- Thêm middleware sinh hoặc nhận
trace_idvàrequest_id. - Chọn 10 đến 15 event name quan trọng: đăng nhập, tạo đơn, thanh toán, gọi provider, xử lý job.
- Tạo dashboard truy vấn theo trace ID, user ID, status code và duration.
- Thêm kiểm tra tự động hoặc code review rule để chặn log chứa token, cookie và secret.
- Mở rộng dần sang worker và service phụ, giữ cùng schema.
Khi làm đúng, log không chỉ là nơi tìm stack trace sau sự cố. Nó trở thành bản đồ vận hành: cho biết request đã đi qua đâu, mất thời gian ở đâu, lỗi bắt đầu ở tầng nào và người dùng nào bị ảnh hưởng.




Chưa có bình luận. Hãy là người đầu tiên chia sẻ ý kiến.