
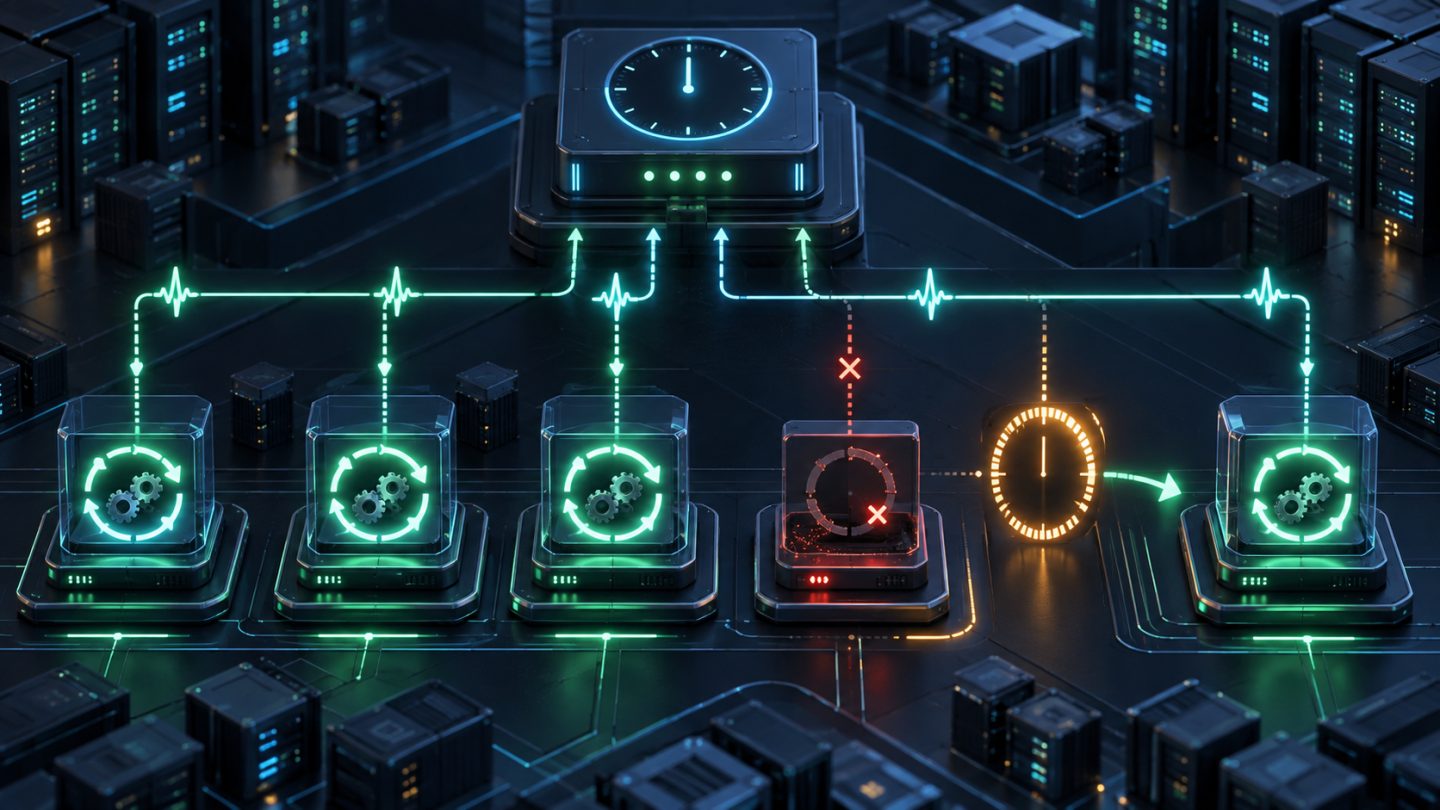
Một process vẫn còn PID không có nghĩa nó còn phục vụ được traffic. Event loop có thể deadlock, kẹt I/O hoặc ngừng tiến triển trong khi systemd vẫn thấy tiến trình “running”. Service watchdog giải quyết khoảng trống này: daemon phải gửi heartbeat định kỳ; nếu nhịp biến mất, systemd đánh dấu service failed, kết thúc tiến trình và có thể khởi động lại theo policy.
Bài viết triển khai WatchdogSec=, Type=notify và sd_notify() theo tài liệu chính thức của systemd về service units, notification protocol và sd_watchdog_enabled(). Trọng tâm là chứng minh tiến triển thật, sizing timeout, tránh restart storm và kiểm thử production an toàn.
1. Watchdog phát hiện lỗi mà process supervision bỏ sót
| Tình trạng | Restart=on-failure | Service watchdog |
|---|---|---|
| Process thoát với mã lỗi | Phát hiện | Không cần chờ watchdog |
| Process bị signal/OOM | Phát hiện tùy policy | Không cần chờ watchdog |
| Main loop deadlock nhưng PID còn sống | Không phát hiện | Phát hiện khi mất heartbeat |
| Dịch vụ trả lỗi nghiệp vụ nhưng loop vẫn chạy | Không phát hiện | Chỉ phát hiện nếu heartbeat gắn với health phù hợp |
Heartbeat chỉ có giá trị khi nó đi qua đúng đường cần giám sát. Một thread riêng cứ ping trong khi worker pool hoặc event loop chính đã chết sẽ tạo tín hiệu xanh giả.
2. Unit nền tảng có readiness và watchdog
# /etc/systemd/system/report-api.service
[Unit]
Description=Report API with service watchdog
After=network.target
StartLimitIntervalSec=5min
StartLimitBurst=3

[Service]
Type=notify
NotifyAccess=main
ExecStart=/usr/local/bin/report-api

TimeoutStartSec=45s
WatchdogSec=30s
WatchdogSignal=SIGABRT

Restart=on-failure
RestartSec=5s
TimeoutStopSec=20s

User=report-api
Group=report-api
NoNewPrivileges=yes

[Install]
WantedBy=multi-user.target
Với Type=notify, startup chỉ hoàn tất sau khi main process gửi READY=1. Watchdog được kích hoạt sau startup. Nếu READY không tới đúng hạn, TimeoutStartSec xử lý lỗi startup; đó không phải watchdog timeout.
NotifyAccess=main giới hạn notification cho main process và là baseline dễ audit. Nếu wrapper/child phải gửi thay, thiết kế PID attribution và lifecycle phải rõ trước khi mở all.
3. Protocol daemon cần thực hiện
- Khởi tạo listener, database pool và dependency bắt buộc.
- Chỉ khi có thể nhận việc mới gửi
READY=1. - Đọc timeout mà systemd cấp qua
sd_watchdog_enabled(). - Gửi
WATCHDOG=1đều đặn, khuyến nghị khoảng nửa timeout. - Khi shutdown, dừng nhận việc, drain và có thể gửi
STOPPING=1.
sd_notify(0, "READY=1\nSTATUS=Accepting requests");

uint64_t watchdog_usec = 0;
int enabled = sd_watchdog_enabled(0, &watchdog_usec);
if (enabled > 0) {
    heartbeat_interval = watchdog_usec / 2;
}

/* Trong chính event loop hoặc sau một kiểm tra progress đáng tin cậy */
if (enabled > 0 && monotonic_now() >= next_heartbeat) {
    int rc = sd_notify(0, "WATCHDOG=1\nSTATUS=Event loop healthy");
    if (rc < 0) log_notify_error(rc);
    next_heartbeat = monotonic_now() + heartbeat_interval;
}
Đừng hardcode nhịp trong code. WATCHDOG_USEC cho phép operator đổi unit mà không rebuild. Hàm helper còn kiểm tra WATCHDOG_PID để child không vô tình kế thừa vai trò heartbeat của parent.
4. Heartbeat phải chứng minh tiến triển
Với single-threaded event loop, timer heartbeat trong cùng loop là tín hiệu tốt: loop bị block thì ping cũng dừng. Với thread pool, một thread giám sát có thể yêu cầu progress counter tăng, queue age dưới ngưỡng và dispatcher hoàn thành một vòng trước khi ping.
Đừng biến heartbeat thành một health check quá nặng gọi database, DNS và mọi dependency ở mỗi nhịp. Dependency outage không nhất thiết được chữa bằng restart local; hàng trăm instance cùng restart có thể làm sự cố nặng hơn. Phân tách:
- Liveness: process nội bộ còn tiến triển hay không.
- Readiness: instance có nên nhận traffic mới hay không.
- Dependency health: upstream/downstream có đạt SLO không.
5. Chọn WatchdogSec theo latency và pause thực tế
Timeout quá ngắn gây false positive khi CPU bị starvation, runtime dừng do GC, host swap, storage stall hoặc scheduler trễ. Timeout quá dài làm tăng thời gian phát hiện treo. Bắt đầu từ SLO phục hồi rồi đo worst-case pause hợp lệ.
Nếu WatchdogSec=30s, ping khoảng 15 giây tạo một khoảng dự phòng. Nhưng “nửa timeout” không thay thế capacity planning: nếu p99.99 event-loop lag đã 20 giây thì timeout 30 giây rất mong manh. Alert event-loop lag và heartbeat delay trước khi watchdog phải hành động.
Dùng monotonic clock cho scheduler heartbeat. Wall clock có thể nhảy vì NTP hoặc thay đổi giờ và không phù hợp để đo deadline.
6. WatchdogSignal, core dump và thời gian kết thúc
Khi timeout, systemd mặc định dùng SIGABRT (hoặc WatchdogSignal=) và service chuyển sang failed. SIGABRT có thể tạo core dump, hữu ích để tìm deadlock nhưng cũng có thể chứa secret và tốn nhiều disk.
Đặt chính sách coredump, quota và retention có chủ đích. Với process lớn, TimeoutAbortSec= có thể dành thời gian ghi dump trước khi systemd dùng final kill signal; nếu quá ngắn dump bị cắt, quá dài làm chậm phục hồi. Khi ưu tiên availability hơn forensics, cân nhắc dump có sampling hoặc chỉ bật trên canary.
7. Restart policy không được trở thành vòng lặp
Restart=on-failure bao gồm watchdog timeout. Restart=on-watchdog hẹp hơn nhưng bỏ qua exit failure khác. Với đa số daemon dài hạn, on-failure là baseline hợp lý; quyết định cuối phải theo failure model của service.
RestartSec tạo khoảng lùi, còn StartLimitIntervalSec/StartLimitBurst đặt ngân sách restart. Nếu version mới treo ngay sau READY, rate limit phải dừng vòng lặp để log và dependency có thời gian hồi phục. Khi limit bị chạm, operator cần sửa nguyên nhân rồi mới dùng systemctl reset-failed; không tự động reset limit vô hạn.
8. Readiness không phải heartbeat
READY=1 là chuyển trạng thái một lần khi startup hoàn tất. WATCHDOG=1 là lease lặp lại chứng minh service còn sống. Gửi READY quá sớm khiến dependent unit hoặc load balancer chuyển traffic vào instance chưa sẵn sàng; gửi WATCHDOG từ startup thread không chứng minh request loop đang chạy.
STATUS= giúp systemctl status hiển thị trạng thái ngắn, nhưng không dùng dữ liệu người dùng, token hoặc exception nguyên văn. Đây là kênh vận hành, không phải kho log không giới hạn.
9. NotifyAccess và tiến trình con
systemd phải quy notification về đúng unit và process được phép. Với main process do systemd khởi chạy trực tiếp, NotifyAccess=main đơn giản nhất. Daemon double-fork, wrapper script hoặc sidecar heartbeat dễ tạo race: sender có thể thoát trước khi manager xử lý message hoặc ping tiếp khi service thật đã treo.
Ưu tiên foreground daemon, main PID rõ và heartbeat trong application. Nếu buộc gửi từ helper, đọc contract của sd_pid_notify()/sd_notify_barrier(), kiểm tra version systemd và đặt test lifecycle riêng; không giải quyết bằng NotifyAccess=all mà không phân tích quyền.
10. Quan sát nguyên nhân restart
systemctl status report-api.service
systemctl show report-api.service \
  -p ActiveState -p SubState -p Result -p NRestarts -p WatchdogUSec

journalctl -u report-api.service --since today
coredumpctl list /usr/local/bin/report-api
Phân biệt Result=watchdog với exit-code, signal, timeout startup, OOM hoặc stop thủ công. Metric nên có watchdog expiry, restart count/rate, event-loop lag, queue age, last successful work time, startup duration và request error/latency sau restart.
Cảnh báo phải xảy ra trước khi rate limit làm unit nằm failed. Một restart đơn lẻ có thể tự phục hồi, nhưng nhiều watchdog expiry trên các host cùng lúc thường là capacity hoặc dependency incident, không phải hàng loạt bug ngẫu nhiên.
11. Kiểm thử failure path có kiểm soát
Trên staging, thêm fault injection có xác thực để chặn chính event loop lâu hơn timeout; không để endpoint này tồn tại công khai. Một phép thử mức process có thể dùng SIGSTOP để dừng main process, sau đó quan sát watchdog và restart:
sudo systemctl kill --kill-whom=main --signal=SIGSTOP report-api.service

# Chờ quá WatchdogSec rồi kiểm tra
systemctl status report-api.service
systemctl show report-api.service -p Result -p NRestarts
journalctl -u report-api.service --since '-2 min'
Chỉ chạy trên staging/canary có traffic cô lập và console truy cập. Xác minh request đang xử lý bị ảnh hưởng thế nào, restart mất bao lâu, core dump có được kiểm soát, alert có tới và start limit có dừng crash loop. Sau test, bảo đảm không còn process bị stop hoặc unit ở failed state.
12. Service watchdog khác hardware watchdog
WatchdogSec= giám sát một service từ systemd. Nếu kernel hoặc PID 1 treo, service watchdog không thể cứu host. RuntimeWatchdogSec= trong system manager có thể dùng thiết bị watchdog phần cứng để reboot máy khi manager không ping được.
Hai tầng bổ sung nhau nhưng blast radius khác: service watchdog restart một workload; hardware watchdog reboot cả host. Không bật hardware watchdog chỉ bằng cách sao chép cấu hình — phải kiểm tra device/driver, fencing, storage, cluster quorum và hành vi reboot thật.
Checklist production
READY=1chỉ gửi sau khi service thực sự nhận được việc.- Heartbeat nằm trong critical event loop hoặc phụ thuộc progress signal đáng tin cậy.
- Daemon đọc
WATCHDOG_USEC/WATCHDOG_PIDqua helper thay vì hardcode. - Nhịp ping có margin; timeout dựa trên event-loop lag và worst-case pause thực tế.
NotifyAccess=mainvà main PID đúng; helper/child có threat model riêng.RestartSeccùng start-rate limit ngăn restart storm.- Core dump có quota, bảo vệ dữ liệu và deadline phù hợp.
- Dashboard phân biệt watchdog, OOM, exit, startup timeout và operator stop.
- Fault injection đã chứng minh detection, alert, restart và recovery trên canary.
- Watchdog không bị dùng thay readiness, dependency health hoặc hardware watchdog.
Kết luận
systemd service watchdog biến “process còn tồn tại” thành một contract mạnh hơn: application phải liên tục chứng minh đường xử lý quan trọng còn tiến triển. Cấu hình WatchdogSec rất ngắn, nhưng thiết kế đúng cần readiness chuẩn, heartbeat đúng vị trí, timeout dựa trên dữ liệu, restart budget, forensic policy và fault test. Khi những phần đó đồng bộ, watchdog rút ngắn thời gian phục hồi deadlock mà không biến một pause hợp lệ thành crash loop.
Chưa có bình luận. Hãy là người đầu tiên chia sẻ ý kiến.