
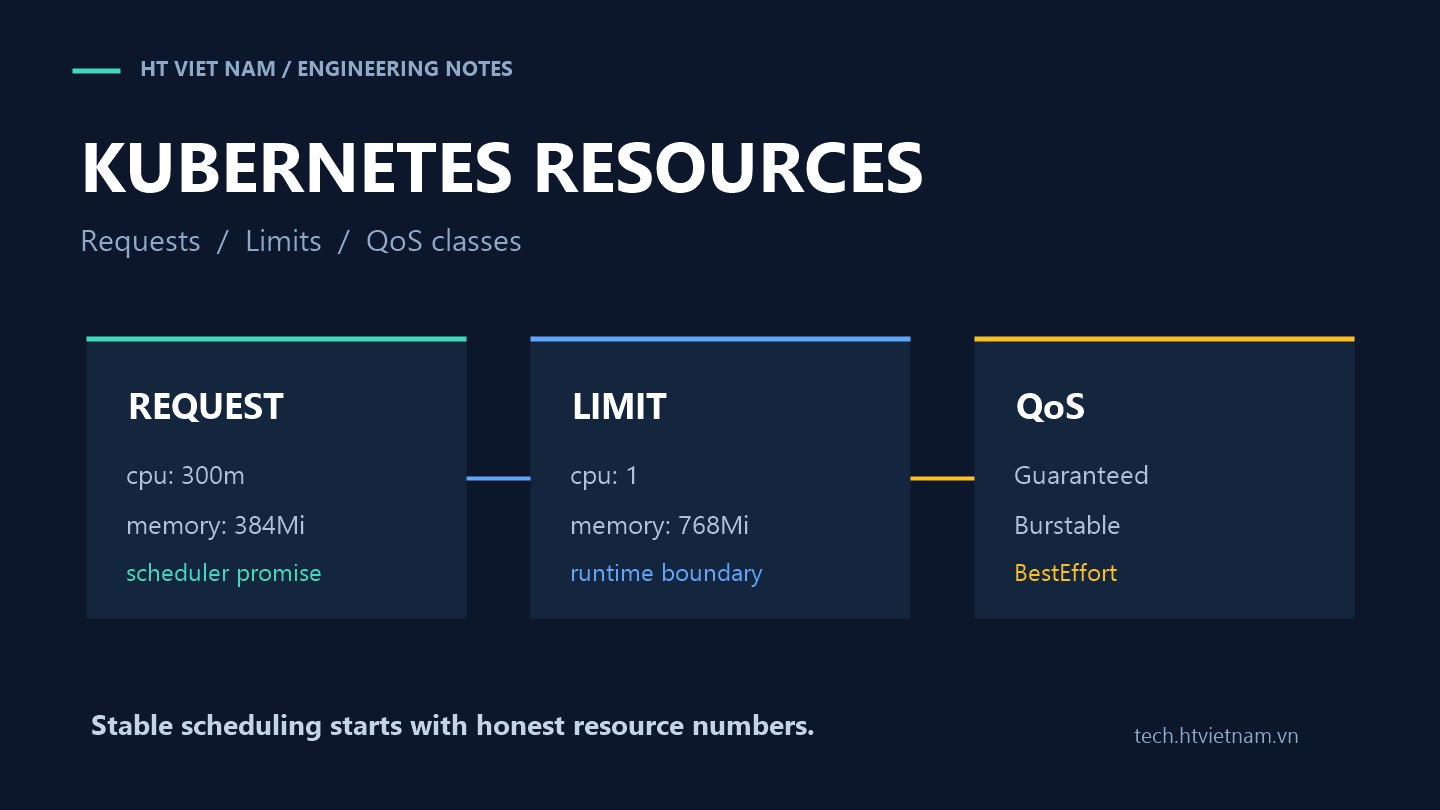
Trong Kubernetes, tài nguyên không chỉ là chuyện “pod cần bao nhiêu CPU và RAM”. Requests quyết định scheduler đặt pod ở đâu, limits quyết định container được phép dùng đến đâu, còn QoS class ảnh hưởng đến pod nào bị đẩy ra trước khi node thiếu tài nguyên. Đặt quá thấp thì ứng dụng tranh tài nguyên và dễ chậm bất thường; đặt quá cao thì cluster lãng phí và pod khó schedule.
1. Request là lời đặt chỗ, limit là hàng rào
Với mỗi container, Kubernetes cho phép khai báo resources.requests và resources.limits cho CPU, memory và một số loại tài nguyên khác. Tài liệu Kubernetes mô tả CPU và memory là compute resources có thể request, allocate và consume; request/limit của pod là tổng request/limit của các container trong pod. Xem Resource Management for Pods and Containers.
resources:
  requests:
    cpu: "250m"
    memory: "256Mi"
  limits:
    cpu: "1"
    memory: "512Mi"
Ví dụ này nói rằng container cần được đặt chỗ 0,25 CPU và 256 MiB RAM, nhưng có thể burst CPU tối đa 1 core và bị giới hạn memory ở 512 MiB. Scheduler dùng request để chọn node; runtime dùng limit để kiểm soát mức sử dụng.
2. CPU request không giống CPU limit
CPU trong Kubernetes đo bằng đơn vị tuyệt đối. 100m nghĩa là 0,1 CPU; 500m nghĩa là nửa CPU. Kubernetes nói một container có request 0,5 CPU được đảm bảo nhiều CPU time bằng một nửa container request 1 CPU, nếu node có tài nguyên phù hợp. Xem Assign CPU Resources to Containers and Pods.
CPU limit là trần sử dụng. Nếu ứng dụng cố dùng nhiều hơn limit, nó có thể bị throttle thay vì bị kill. Điều này khác memory: CPU thường chậm lại khi bị giới hạn, còn memory vượt limit có thể dẫn đến OOM kill. Với backend latency-sensitive, CPU limit quá thấp có thể tạo p95/p99 latency xấu dù average CPU nhìn không cao.
3. Memory limit là ranh giới cứng hơn
Memory request giúp scheduler biết cần đặt chỗ bao nhiêu RAM. Memory limit giới hạn container được dùng bao nhiêu. Tài liệu Kubernetes về memory nêu rằng container được đảm bảo có lượng memory bằng request, nhưng không được phép dùng quá limit. Xem Assign Memory Resources to Containers and Pods.
Nếu backend có heap, cache trong process hoặc xử lý file lớn, memory limit cần tính cả overhead ngoài dữ liệu nghiệp vụ. Với JVM, Node.js, PHP-FPM hay Go service, hãy đo RSS thực tế dưới tải gần production, rồi đặt request/limit dựa trên dữ liệu thay vì đoán từ máy dev.
4. QoS class ảnh hưởng đến eviction
Kubernetes gán mỗi pod vào một QoS class: Guaranteed, Burstable hoặc BestEffort. Khi node thiếu tài nguyên, Kubernetes dùng phân loại này để quyết định pod nào bị evict trước. Tài liệu Kubernetes nói BestEffort bị evict trước, tiếp theo là Burstable, và cuối cùng là Guaranteed. Xem Pod Quality of Service Classes.
- Guaranteed: mọi container có CPU/memory request bằng limit.
- Burstable: ít nhất một request/limit được đặt, nhưng không thỏa Guaranteed.
- BestEffort: không đặt request và limit CPU/memory.
Không phải workload nào cũng cần Guaranteed. Nhiều backend phù hợp với Burstable: request đủ thật để schedule ổn, limit đủ rộng để burst có kiểm soát. Nhưng BestEffort cho service quan trọng thường là dấu hiệu thiếu cấu hình.
5. Vì sao không nên copy cấu hình giữa mọi service?
Một API đọc nhiều cache khác với worker xử lý ảnh. Một cron job chạy theo đợt khác với service nhận request đều đặn. Copy cấu hình cpu: 500m, memory: 512Mi cho mọi thứ tạo cảm giác chuẩn hóa, nhưng thực ra che mất hành vi riêng của từng workload.
Hãy nhìn theo ba câu hỏi: service cần bao nhiêu tài nguyên khi bình thường, cần burst bao nhiêu khi tải tăng, và điều gì xảy ra nếu nó bị chậm hoặc bị restart? Endpoint người dùng cần request chắc hơn; batch job có thể chấp nhận chậm hơn; worker idempotent có thể restart an toàn hơn API đang giữ kết nối người dùng.
6. Một cấu hình Deployment thực tế
apiVersion: apps/v1
kind: Deployment
metadata:
  name: checkout-api
spec:
  replicas: 3
  selector:
    matchLabels:
      app: checkout-api
  template:
    metadata:
      labels:
        app: checkout-api
    spec:
      containers:
        - name: app
          image: example.com/checkout-api:2026.09.21
          ports:
            - containerPort: 8080
          resources:
            requests:
              cpu: "300m"
              memory: "384Mi"
            limits:
              cpu: "1"
              memory: "768Mi"
Đây không phải con số mẫu để dùng cho mọi ứng dụng. Điểm chính là request phản ánh mức service cần để chạy ổn định, còn limit cho phép burst nhưng vẫn bảo vệ node khỏi một container runaway.
7. Đặt limit sai có thể tạo sự cố khó nhìn
CPU limit quá thấp có thể làm ứng dụng bị throttle ngay lúc traffic tăng, khiến latency tăng và readiness probe bắt đầu fail. Memory limit quá sát có thể làm pod bị kill khi GC chưa kịp chạy hoặc khi cache warm-up. Request quá cao khiến pod Pending dù node còn tài nguyên chưa được request; request quá thấp khiến node bị overcommit và workload quan trọng tranh tài nguyên.
Đừng chỉ nhìn pod có Running hay không. Hãy theo dõi throttling, OOMKilled, restart count, latency, memory working set, RSS và saturation ở node. Nếu có autoscaling, requests còn ảnh hưởng đến cách HPA tính utilization, nên cấu hình tài nguyên sai có thể kéo theo scaling sai.
8. Lộ trình đặt requests/limits an toàn hơn
- Bắt đầu bằng số đo thật: CPU, memory, latency và restart trong giờ cao điểm.
- Đặt request gần mức cần để service chạy ổn định, không dựa trên peak hiếm gặp.
- Đặt memory limit đủ cao hơn working set và kiểm tra OOMKilled sau deploy.
- Cẩn trọng với CPU limit cho service cần latency thấp; đo throttling trước khi siết.
- Phân loại workload: API, worker, cron, queue consumer và job batch không dùng chung một mẫu.
- Dùng namespace defaults hoặc policy để tránh pod BestEffort ngoài ý muốn.
- Review lại định kỳ vì traffic, code và dependency thay đổi theo thời gian.
Requests và limits tốt không làm hệ thống nhanh lên một cách thần kỳ. Chúng giúp Kubernetes ra quyết định đúng hơn: pod nào được schedule ở đâu, pod nào được bảo vệ khi node căng tài nguyên và workload nào được phép burst trong giới hạn hợp lý. Với backend production, đó là nền tảng nhỏ nhưng ảnh hưởng rất lớn đến độ ổn định.




Chưa có bình luận. Hãy là người đầu tiên chia sẻ ý kiến.