
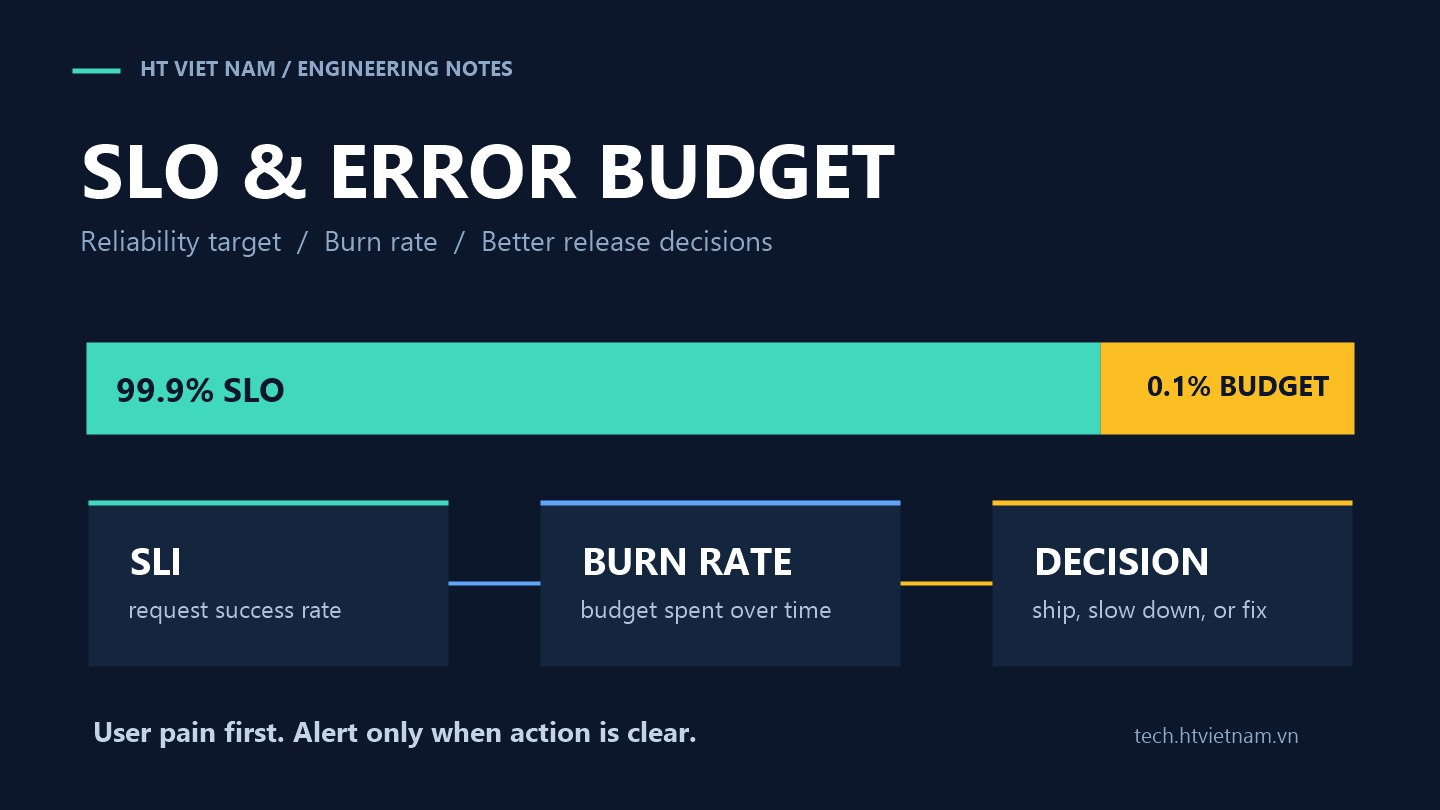
“Hệ thống có ổn không?” là câu hỏi nghe đơn giản nhưng rất dễ trả lời bằng cảm giác. Dashboard xanh chưa chắc người dùng hài lòng, còn vài lỗi lẻ tẻ chưa chắc là sự cố cần đánh thức cả đội. SLO và error budget giúp biến cảm giác đó thành một thước đo đủ rõ để ra quyết định: lúc nào tiếp tục ship tính năng, lúc nào phải ưu tiên ổn định.
1. SLO là lời hứa nội bộ có thể đo được
SLO, viết tắt của Service Level Objective, là mục tiêu độ tin cậy cho một dịch vụ trong một khoảng thời gian. Ví dụ: “99,9% request checkout thành công trong 28 ngày” hoặc “95% request tìm kiếm trả về dưới 300 ms”. Một SLO tốt phải gắn với trải nghiệm người dùng, đo được bằng dữ liệu thật và đủ đơn giản để đội kỹ thuật cùng hiểu.
Đừng bắt đầu bằng mọi metric có sẵn. Hãy bắt đầu từ hành trình quan trọng: đăng nhập, đặt hàng, thanh toán, xuất hóa đơn, gửi thông báo. Mỗi hành trình cần một hoặc vài chỉ số SLI, tức Service Level Indicator, để đo chất lượng thực tế.
2. Error budget là phần lỗi được phép xảy ra
Error budget là phần còn lại sau mục tiêu SLO. Google SRE Workbook diễn giải rất trực tiếp: error budget bằng 1 trừ SLO; nếu SLO là 99,9%, ngân sách lỗi là 0,1%. Với 1.000.000 request trong 4 tuần, ngân sách đó tương đương 1.000 request lỗi. Xem Error Budget Policy for Service Reliability.
Điểm hay của error budget là nó không giả vờ hệ thống phải hoàn hảo tuyệt đối. Một dịch vụ 100% ổn định thường quá đắt, chậm đổi mới và vẫn không thực tế. Ngân sách lỗi cho phép đội cân bằng giữa thay đổi sản phẩm và độ ổn định mà người dùng thật sự cần.
3. Chọn SLI theo triệu chứng người dùng thấy
Với API backend, ba nhóm SLI thường dễ bắt đầu:
- Availability: tỷ lệ request thành công, thường loại trừ lỗi do client gửi sai dữ liệu.
- Latency: phần trăm request hoàn thành dưới một ngưỡng, ví dụ p95 dưới 300 ms.
- Correctness: tác vụ trả kết quả đúng hoặc job xử lý xong trong thời hạn.
Prometheus khuyến nghị alert trên triệu chứng gắn với nỗi đau người dùng, như latency cao và error rate ở tầng cao nhất có thể, thay vì bắt mọi nguyên nhân kỹ thuật nhỏ. Xem Prometheus alerting practices.
4. Ví dụ SLO cho checkout API
Giả sử checkout API có 2.000.000 request trong 28 ngày. Đội đặt SLO availability là 99,9% cho request hợp lệ. Error budget của kỳ này là:
2,000,000 * (1 - 0.999) = 2,000 request lỗi được phépNếu trong tuần đầu đã có 1.400 request lỗi, đội đã dùng 70% ngân sách lỗi dù mới đi qua 25% thời gian. Đây là tín hiệu rõ hơn nhiều so với câu “tuần này hơi nhiều lỗi”. Lúc đó có thể tạm giảm rollout rủi ro, ưu tiên fix luồng thanh toán, hoặc tăng giám sát các dependency đang gây lỗi.
5. Alert theo tốc độ đốt budget
Alert tốt không chỉ hỏi “hiện tại có lỗi không”, mà hỏi “nếu tốc độ lỗi này tiếp tục, chúng ta có đốt hết ngân sách quá nhanh không”. Một spike 2 phút có thể không cần gọi người trực nếu tự hồi phục và không ăn nhiều budget. Ngược lại, lỗi âm ỉ ở mức thấp nhưng kéo dài có thể phá SLO cả tháng.
Prometheus tách phần alerting thành rule trong Prometheus server và phần điều phối thông báo trong Alertmanager, nơi xử lý grouping, inhibition, silence và kênh gửi thông báo. Xem Prometheus Alerting overview.
# Minh họa ý tưởng burn rate, không phải rule copy-paste cho mọi hệ thống
error_rate_5m  = failed_requests_5m / total_requests_5m
budget_rate    = 1 - 0.999
burn_rate_5m   = error_rate_5m / budget_rate
Khi burn rate cao trong cửa sổ ngắn, đội cần phản ứng nhanh. Khi burn rate vừa phải nhưng kéo dài trong cửa sổ dài, đội cần điều tra gốc rễ và lên kế hoạch sửa bền hơn.
6. SLO không nên biến thành hình phạt
Error budget hoạt động tốt nhất khi nó là cơ chế ra quyết định chung, không phải bảng phạt. Nếu budget còn nhiều, đội có thể chấp nhận rollout có kiểm soát. Nếu budget gần cạn, cả product và engineering có lý do rõ ràng để chuyển trọng tâm sang ổn định.
Chính sách nên ghi trước: bao nhiêu phần trăm budget bị đốt thì cần postmortem, khi nào tạm dừng rollout, khi nào ưu tiên nợ kỹ thuật ảnh hưởng reliability. Google SRE Workbook nêu ví dụ: một sự cố tiêu thụ hơn 20% error budget trong 4 tuần thì cần postmortem và action item ưu tiên cao.
7. Ghi SLO như code để dễ review
SLO nên sống gần quy trình vận hành của đội, không chỉ nằm trong slide. OpenSLO cung cấp đặc tả YAML vendor-agnostic để mô tả service, SLI, SLO, alert policy và notification target. Mục tiêu của dự án là giúp định nghĩa SLO theo cách trung lập với nhà cung cấp. Xem OpenSLO và OpenSLO specification.
apiVersion: openslo/v1
kind: SLO
metadata:
  name: checkout-availability
spec:
  service: checkout
  objectives:
    - displayName: Checkout successful requests
      targetPercent: 99.9
      timeWindow:
        - duration: 28d
      indicator:
        ratioMetric:
          counter: true
          good:
            metricSource:
              metricSourceRef: prometheus
              query: sum(rate(http_requests_total{service="checkout",status!~"5.."}[5m]))
          total:
            metricSource:
              metricSourceRef: prometheus
              query: sum(rate(http_requests_total{service="checkout"}[5m]))
Ví dụ trên chỉ minh họa cấu trúc. Trong hệ thống thật, cần thống nhất cách phân loại lỗi do server, lỗi do client, timeout ở gateway, retry và request bị hủy giữa chừng.
8. Lộ trình áp dụng cho đội nhỏ
- Chọn một luồng quan trọng nhất, ví dụ đăng nhập hoặc thanh toán.
- Định nghĩa một SLI availability và một SLI latency dựa trên dữ liệu đã có.
- Đặt SLO đủ thực tế, thường thấp hơn một chút so với hiệu năng tốt nhất hiện tại.
- Tạo dashboard hiển thị error budget còn lại, burn rate và sự cố gần đây.
- Chỉ tạo alert khi có hành động rõ ràng cho người trực.
- Sau một hoặc hai chu kỳ, điều chỉnh SLO theo dữ liệu và kỳ vọng sản phẩm.
SLO tốt giúp đội nói chuyện bằng cùng một ngôn ngữ: người dùng đang chịu ảnh hưởng ở mức nào, rủi ro đổi mới còn bao nhiêu và công việc ổn định nào thật sự đáng ưu tiên. Khi đó reliability không còn là cảm giác mơ hồ sau mỗi sự cố, mà là một phần của cách đội vận hành sản phẩm.




Chưa có bình luận. Hãy là người đầu tiên chia sẻ ý kiến.