
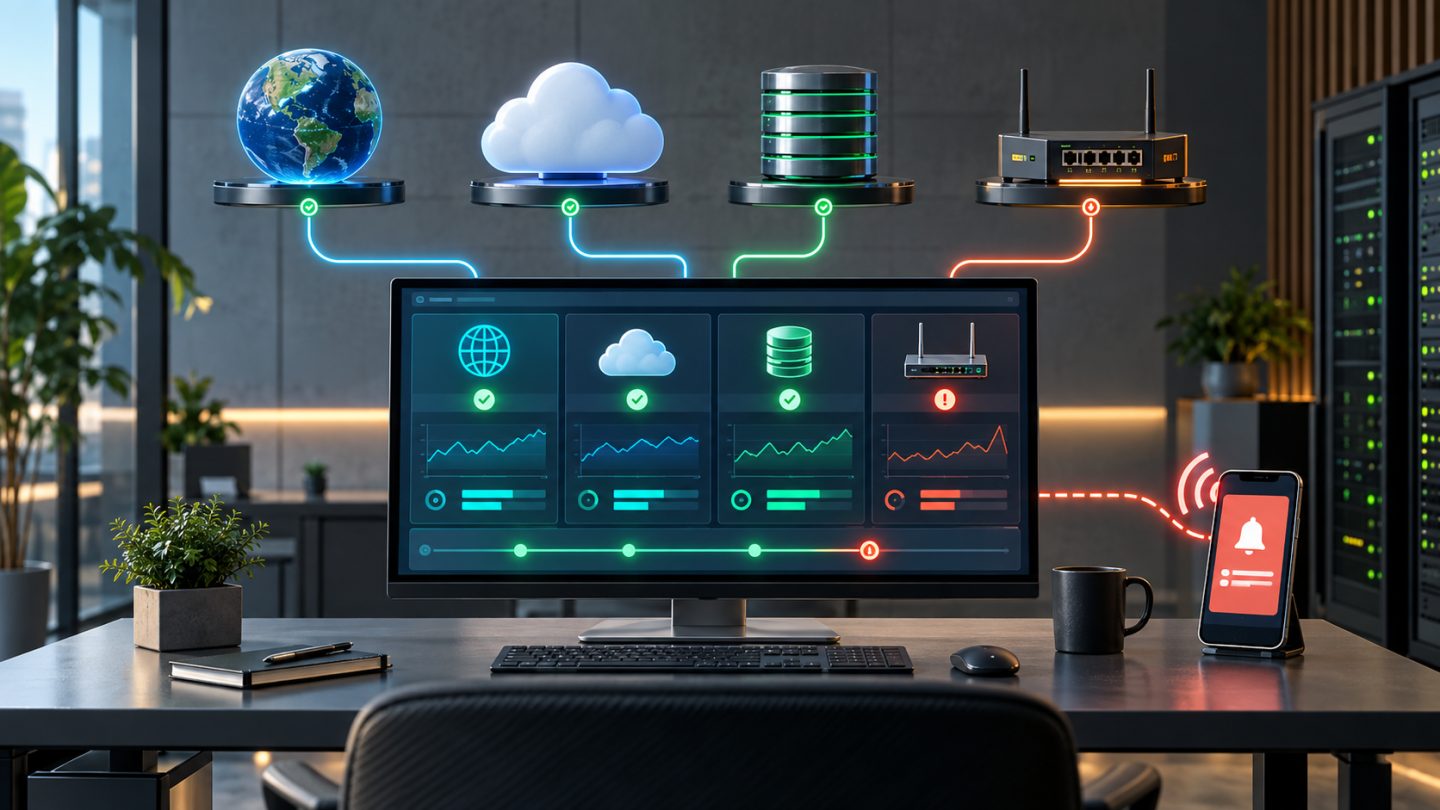
Một hệ thống giám sát tốt không phải hệ thống có nhiều biểu đồ nhất, mà là hệ thống phát hiện đúng sự cố, báo đúng người và đưa đủ thông tin để hành động. Với doanh nghiệp nhỏ, mục tiêu nên là nhìn thấy trải nghiệm của khách hàng, sức khỏe hạ tầng và rủi ro sắp xảy ra mà không tạo thêm một nền tảng quá phức tạp để vận hành.
Bắt đầu từ câu hỏi kinh doanh
Trước khi chọn công cụ, hãy xác định dịch vụ nào ảnh hưởng trực tiếp đến doanh thu hoặc hoạt động: website bán hàng, API, email, VPN, phần mềm nội bộ, database hay đường truyền văn phòng. Mỗi dịch vụ cần một chủ sở hữu, thời gian hoạt động mong muốn và mức gián đoạn chấp nhận được.
Ví dụ, website giới thiệu có thể chấp nhận phản hồi trong giờ hành chính, còn checkout hoặc API nhận đơn cần cảnh báo ngay. Nếu mọi sự kiện đều được xếp mức khẩn cấp, đội ngũ sẽ nhanh chóng bỏ qua cảnh báo.
Bốn lớp giám sát cần thiết
| Lớp | Câu hỏi trả lời | Tín hiệu chính |
|---|---|---|
| Kiểm tra bên ngoài | Khách hàng có truy cập được không? | HTTP, DNS, TLS, TCP, nội dung trang, thời gian phản hồi |
| Hạ tầng | Máy chủ có sắp cạn tài nguyên không? | CPU, RAM, disk, inode, network, load, service |
| Ứng dụng | Ứng dụng có phục vụ đúng và đủ nhanh không? | Request rate, error rate, latency, queue, database connections |
| Nghiệp vụ | Luồng tạo giá trị có hoạt động không? | Đơn hàng, thanh toán, đăng nhập, email giao dịch, đồng bộ dữ liệu |
Chỉ ping server là chưa đủ: máy có thể trả lời ping trong khi website lỗi 500. Ngược lại, CPU cao chưa chắc khách hàng bị ảnh hưởng. Cần kết hợp tín hiệu hướng người dùng với dữ liệu nội bộ để vừa phát hiện vừa chẩn đoán.
Kiến trúc tối thiểu cho doanh nghiệp nhỏ
Một kiến trúc thực dụng gồm:
- Một dịch vụ uptime đặt ngoài hạ tầng chính để kiểm tra website, API, DNS và chứng chỉ TLS.
- Agent hoặc exporter trên server để phát metrics tài nguyên và dịch vụ.
- Kho metrics theo chuỗi thời gian, chẳng hạn Prometheus, khi cần lịch sử và truy vấn sâu.
- Dashboard, chẳng hạn Grafana, để điều tra và theo dõi xu hướng.
- Alert manager hoặc cơ chế thông báo có grouping, silence và routing.
- Kênh thông báo độc lập với hệ thống đang được giám sát.
Không đặt toàn bộ monitoring trên cùng máy chủ với website. Khi máy đó mất điện hoặc đầy disk, hệ thống giám sát cũng biến mất và không thể báo lỗi.
Chọn công cụ theo độ trưởng thành
Mức 1: Một vài website hoặc VPS
Dùng dịch vụ uptime được quản lý hoặc công cụ self-hosted gọn nhẹ để kiểm tra HTTP, keyword, TCP và TLS. Thêm cảnh báo disk, RAM và service từ nhà cung cấp VPS. Đây là mức phù hợp khi chưa có người chuyên vận hành.
Mức 2: Nhiều server và ứng dụng
Dùng Prometheus thu thập time-series metrics qua HTTP, exporters cho hệ điều hành và ứng dụng, Grafana cho dashboard, Alertmanager hoặc Grafana Alerting cho thông báo. Stack này linh hoạt nhưng cần người chịu trách nhiệm cập nhật, backup, retention và bảo mật.
Mức 3: Nhiều dịch vụ hoặc yêu cầu trực ca
Bổ sung log tập trung, tracing, SLO, on-call schedule, escalation và quản lý incident. Chỉ nâng cấp khi độ phức tạp giúp giảm thời gian phát hiện hoặc khắc phục; không triển khai đủ bộ observability chỉ vì công cụ có sẵn.
Những monitor đầu tiên nên tạo
- Website chính: HTTPS 200, kiểm tra một chuỗi nội dung quan trọng và latency.
- API health: endpoint nhẹ nhưng kiểm tra được dependency cốt lõi.
- DNS: phân giải đúng IP hoặc record quan trọng.
- TLS: cảnh báo trước khi chứng chỉ hết hạn 30, 14 và 7 ngày.
- Luồng nghiệp vụ tổng hợp: đăng nhập thử hoặc tạo giao dịch sandbox nếu rủi ro cho phép.
- Server: disk, inode, RAM, load, network và service process.
- Database: kết nối, query latency, storage, replication và backup status.
- Queue: độ dài, tuổi job lâu nhất, failed jobs và worker count.
- Backup: thời điểm thành công gần nhất và kết quả restore test, không chỉ trạng thái job.
Áp dụng tín hiệu vàng thay vì theo dõi mọi thứ
Với dịch vụ web, bốn nhóm tín hiệu hữu ích là latency, traffic, errors và saturation. Chúng trả lời người dùng có bị chậm hay lỗi, tải đang ở mức nào và tài nguyên nào gần giới hạn. Dashboard hạ tầng vẫn cần thiết, nhưng cảnh báo đánh thức người trực nên ưu tiên triệu chứng tác động đến người dùng.
Ví dụ, CPU 90% trong một phút có thể là tác vụ bình thường. Tỷ lệ lỗi 5% kéo dài năm phút trên checkout thường đáng báo hơn. Hãy dùng cửa sổ thời gian và điều kiện kéo dài để giảm cảnh báo do spike ngắn.
Thiết kế cảnh báo có hành động
Mỗi cảnh báo cần trả lời sáu câu hỏi:
- Dịch vụ nào gặp vấn đề?
- Khách hàng hoặc nghiệp vụ bị ảnh hưởng ra sao?
- Tín hiệu nào vượt ngưỡng và kéo dài bao lâu?
- Mức độ khẩn cấp là gì?
- Ai chịu trách nhiệm?
- Runbook và dashboard điều tra ở đâu?
Prometheus tách việc đánh giá rule khỏi gửi thông báo: alert rule tạo alert, còn Alertmanager thực hiện grouping, inhibition, silence và routing. Mô hình này giúp gom nhiều cảnh báo cùng nguyên nhân và tránh gửi hàng chục thông báo khi một database làm nhiều dịch vụ lỗi theo.
Ba mức độ thông báo
| Mức | Ví dụ | Kênh |
|---|---|---|
| Critical | Checkout không hoạt động, mất dữ liệu, API lỗi diện rộng | Cuộc gọi hoặc push tới người trực, có escalation |
| Warning | Disk tăng nhanh, latency cao nhưng chưa vượt SLO | Kênh vận hành trong giờ làm việc |
| Info | Deploy, backup hoàn tất, certificate vừa gia hạn | Dashboard hoặc nhật ký, không đánh thức người trực |
Nếu không có hành động cụ thể, sự kiện nên nằm trên dashboard thay vì thành alert. Rà soát cảnh báo hàng tháng: cảnh báo nào không dẫn tới hành động cần được sửa hoặc loại bỏ.
Dashboard dành cho quyết định
Không nhồi mọi metric vào một màn hình. Nên có ba dashboard:
- Tổng quan dịch vụ: availability, latency, error rate, traffic và sự cố đang mở.
- Điều tra: CPU, RAM, disk, database, queue, dependency và deploy marker.
- Năng lực: xu hướng 30-90 ngày, tốc độ tăng storage, peak traffic và dự báo giới hạn.
Mỗi biểu đồ cần đơn vị, nguồn dữ liệu và phạm vi rõ ràng. Average latency có thể che request rất chậm; dùng percentile như p95 hoặc p99 khi thích hợp.
Runbook biến cảnh báo thành phản ứng
Runbook ngắn nên chứa cách xác minh, thay đổi an toàn đầu tiên, điều kiện rollback, người cần gọi và bằng chứng phải lưu. Ví dụ alert disk sắp đầy liên kết tới quy trình kiểm tra filesystem, inode, log, container và file đã xóa còn mở.
Trong maintenance, dùng silence có phạm vi và thời hạn thay vì tắt toàn bộ alert. Sau maintenance, xác nhận monitor đã trở lại và silence tự hết hạn.
Bảo mật hệ thống monitoring
- Không mở dashboard hoặc endpoint metrics ra Internet nếu không cần.
- Dùng HTTPS, SSO/MFA và phân quyền đọc/ghi.
- Không đưa password, token, email khách hàng hay query nhạy cảm vào label metrics.
- Bảo vệ webhook cảnh báo và xoay secret định kỳ.
- Giới hạn cardinality; label chứa user ID hoặc request ID có thể làm kho metrics tăng rất nhanh.
- Sao lưu cấu hình, dashboard, rule và contact point.
- Đặt monitoring ở failure domain khác với workload quan trọng.
Lộ trình triển khai trong 30 ngày
- Tuần 1: lập danh sách dịch vụ, owner, mức quan trọng và kênh liên hệ.
- Tuần 2: triển khai external uptime, TLS expiry và cảnh báo backup.
- Tuần 3: thu metrics server/ứng dụng, tạo dashboard tổng quan và năm alert quan trọng nhất.
- Tuần 4: diễn tập một website down, một disk gần đầy và một cảnh báo giả; chỉnh threshold, routing và runbook.
Đo hai chỉ số vận hành cơ bản: thời gian phát hiện trung bình và thời gian khôi phục trung bình. Mục tiêu đầu tiên không phải đạt dashboard đẹp, mà là phát hiện trước khách hàng và giảm thời gian loay hoay khi sự cố xảy ra.
Ước tính chi phí đúng cách
Self-hosted không đồng nghĩa miễn phí. Chi phí gồm máy chủ monitoring, storage metrics/log, backup, cập nhật, bảo mật và thời gian trực. Dịch vụ managed có phí thuê bao nhưng giảm công vận hành. Với nhóm nhỏ, mô hình hybrid thường hợp lý: external uptime từ bên ngoài, metrics nội bộ tự quản lý hoặc managed tùy năng lực.
Đừng lưu mọi metric mãi mãi. Chọn scrape interval và retention theo nhu cầu điều tra, báo cáo và capacity planning. Dữ liệu chi tiết có thể giữ ngắn, dữ liệu tổng hợp giữ lâu hơn.
Checklist nghiệm thu
- Mỗi dịch vụ quan trọng có owner và mức độ ưu tiên.
- Monitoring bên ngoài không phụ thuộc cùng hạ tầng với website.
- Có kiểm tra HTTP, DNS, TLS và luồng nghiệp vụ quan trọng.
- Server, database, queue và backup có tín hiệu cần thiết.
- Cảnh báo có thời gian chờ để tránh spike và có người nhận rõ ràng.
- Mỗi alert critical liên kết tới dashboard và runbook.
- Đã kiểm tra kênh thông báo và escalation bằng diễn tập.
- Dashboard, rule và cấu hình được backup.
- Có lịch rà soát alert noise và capacity hàng tháng.
Kết luận
Giải pháp giám sát phù hợp cho doanh nghiệp nhỏ nên bắt đầu từ dịch vụ quan trọng và phản ứng của con người, không bắt đầu từ danh sách công cụ. Một external check đáng tin, vài metric đúng, cảnh báo có owner và runbook thường tạo nhiều giá trị hơn hàng trăm dashboard. Khi hệ thống lớn dần, Prometheus, Grafana và alert routing cung cấp đường mở rộng mà không buộc doanh nghiệp phải triển khai tất cả ngay từ ngày đầu.
Chưa có bình luận. Hãy là người đầu tiên chia sẻ ý kiến.